
部署一致性分析说明
从 qat.pt / qat model 到最终部署使用的 hbm,中间还会经过 export、convert、compile 以及部署适配等多个步骤。
如果这些步骤中的某一段引入了额外误差,就可能出现“训练侧结果正常,但部署侧结果不符合预期”的情况。
此章节主要介绍在 QAT 策略上如何避免这类问题,以及发生这类问题时如何定位并解决问题。
训练部署无法做到比特一致,必然存在极少数 case 无法完全对齐, 因此,是否存在一致性问题,应当以数据集上的评测精度、稳定可复现的 badcase,以及多帧可视化结果作为判断依据,而不是只看单帧数值是否完全相同。
训练部署一致性问题分为两类:
-
用户侧问题。例如:前后处理不一致,模型版本不一致等。
-
工具侧问题。模型在 export / convert / compile 过程中引入了额外误差而产生的不一致。
无论问题最终属于用户侧还是工具侧,我们都建议您结合训练部署一致性分析方法,以及相关排查工具和调试产物完成定位。 对于用户侧问题,通常需要您根据排查结果自行修正。 而在完成明显用户侧问题的初步排除后,通常仍需按 export / convert / compile 阶段继续定位,不同类型问题的排查重点并不完全一样。 如果最终确认为工具侧问题,建议您保留对应阶段的调试产物、badcase 和关键模型产物,并提供给地平线技术支持人员,以便进一步分析并给出解决方案。
在一致性问题的排查过程中,涉及到以下几种模型:
| 产物 | 类型 | 获取阶段 | 说明 | 获取方法 | 常见用途 |
qat.pt | torch qat 模型 | Prepare / Calibration / QAT 后 | torch 侧的伪量化模型 | 对浮点模型使用 prepare 接口 | 作为训练侧精度基线,继续执行 pre_export / export |
qat.export.pt | torch qat export 模型 | pre_export 后 | 仅完成查表转定点的 torch 模型,计算逻辑与 qat.bc 更接近 | 对 qat.pt 模型使用 pre_export 接口 | export 阶段一致性分析、查表问题定位 |
qat.bc | 导出产生的 HBIR 模型 | export 后 | 由 qat.pt 导出的 HBIR 模型 | 对 qat.pt 模型使用 export 接口 | export 结果验证、convert 输入 |
quantized.bc | 转换生成的 HBIR 模型 | convert 后 | 由 qat.bc 定点化得到的模型 | 对 qat.bc 模型使用 convert 接口 | compile 前定点精度验证、convert 阶段排查 |
hbm | 编译产生的可部署模型 | compile 后 | 最终部署模型 | 对 quantized.bc 模型使用 compile 接口 | 最终部署精度验证、compile / 板端问题排查 |
其中,比较容易混淆的两点如下:
-
qat.export.pt不是部署主链路中的必选产物,但在 export 阶段排查时非常关键。它主要用于先判断问题是否由查表转定点引入。 -
quantized.bc是进入 compile 之前最值得优先关注的定点精度基线。如果quantized.bc已经异常,就不应直接把问题归因到 compile 或板端部署。
pre_export 接口基本用法如下:
一致性问题定位起点
在进入 export / convert / compile 三个阶段的具体排查之前,建议您先完成下面几件事:
-
准备一份可稳定复现问题的数据集。通常建议至少包含 1000 帧,并且数据集上的评测结果相对稳定。
-
先适配好
bc模型在 x86 侧的推理流程。 -
先排除明显的用户侧问题,再进入按 export / convert / compile 阶段进行的分阶段排查。
原始定位流程如下图所示:
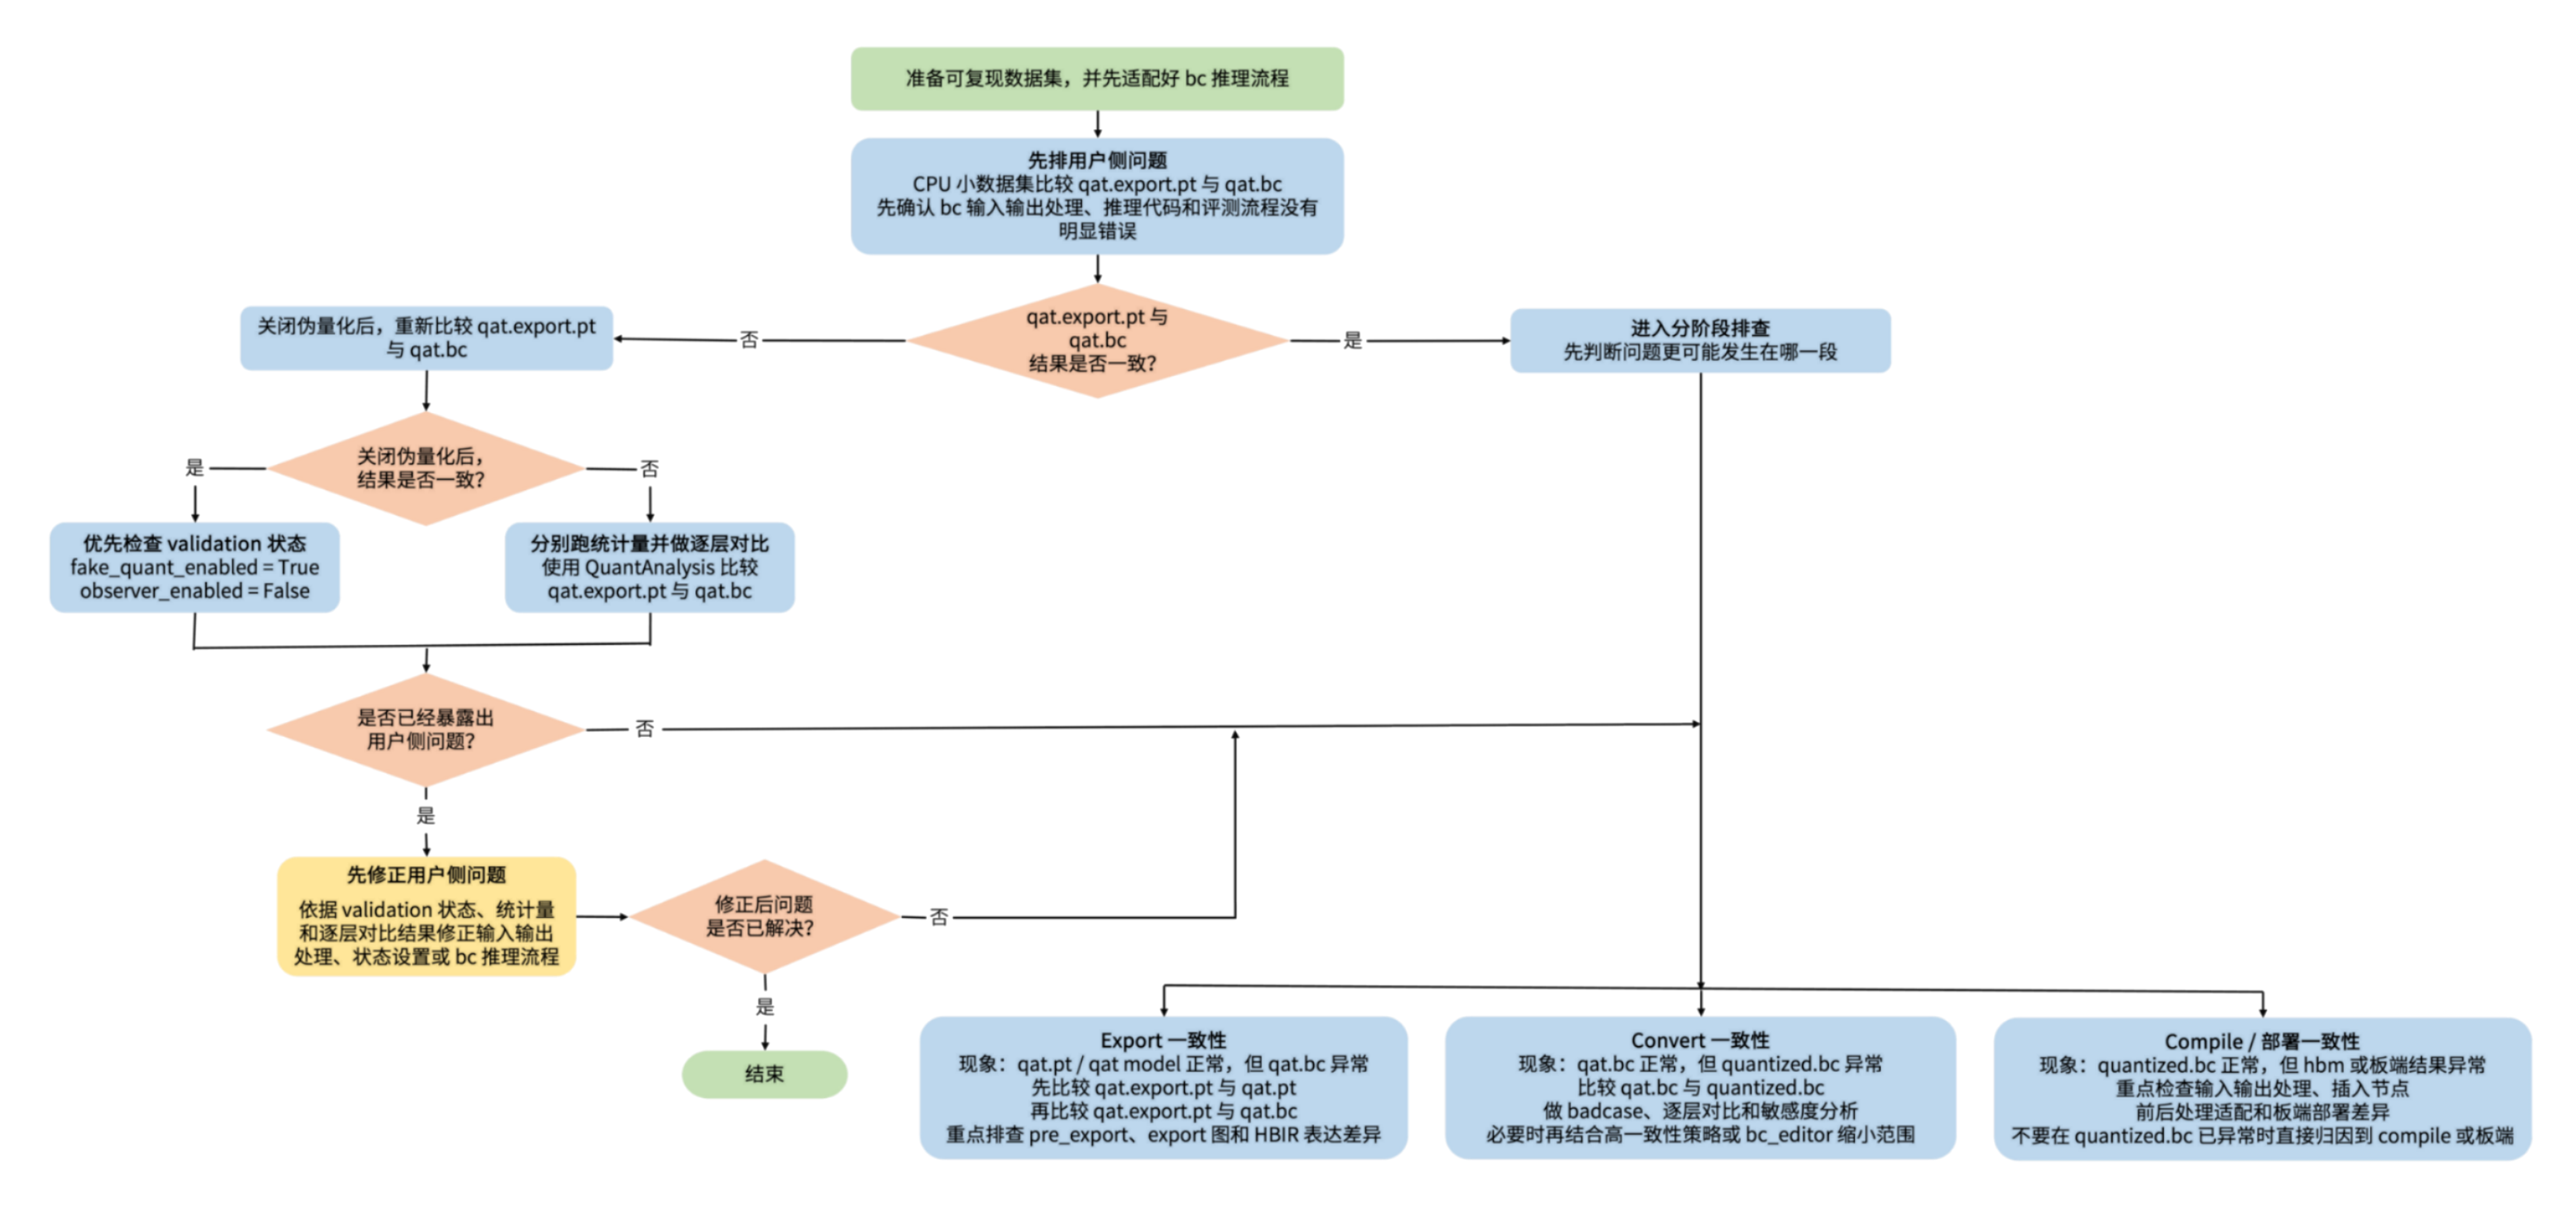
在正式进入一致性排查前,建议您先用小数据集在 CPU 上比较 qat.export.pt 和 qat.bc,先验证 bc 推理流程是否正确。
这一步的目的不是直接定位 export、convert 或 compile 阶段的问题,而是先排除明显的用户侧问题,确认后续用于比较 bc 模型的输入输出处理、推理代码和评测流程本身没有明显错误。
如果两者精度不一致,建议先关闭伪量化,再重新验证 qat.export.pt 和 qat.bc 的结果是否一致:
关闭伪量化后,常见会出现两种情况:
- 如果关闭伪量化后结果一致,通常应优先检查关闭之前模型的 fake quant 和 observer 状态是否处于 validation 状态。
- 如果关闭伪量化后结果仍不一致,建议先对
qat.export.pt和qat.bc分别跑统计量,再做逐层对比。
如果这一步已经暴露出明显的输入输出处理差异、状态设置问题或 bc 推理流程错误,建议先修正这些用户侧问题,再继续进入下文的分阶段排查。
快速判断问题更可能发生在哪一段
实际排查时,建议您先不要一上来就跑完整套工具,而是先用现象判断问题更可能落在哪一段。
| 当前现象 | 优先怀疑阶段 | 建议先做什么 |
|---|---|---|
qat.pt / qat model 正常,但 qat.bc 异常 | export 阶段 | 先比较 qat.export.pt 与 qat.pt,再比较 qat.export.pt 与 qat.bc |
qat.bc 正常,但 quantized.bc 异常 | convert 阶段 | 直接比较 qat.bc 与 quantized.bc,做 badcase、逐层对比和敏感度分析 |
quantized.bc 正常,但 hbm 异常 | compile / 部署阶段 | 重点检查输入输出处理、插入节点、前后处理适配和板端部署差异 |
如果还不能快速判断,也建议至少先完成下面两件事:
-
确认
plugin / profiler / hbdk已升级到当前建议版本。 -
先验证
quantized.bc的精度是否满足预期,再决定是否继续往 compile 或板端方向排查。
建议的排查顺序
如果您当前还不确定应该从哪开始,通常建议按下面的顺序处理:
-
先确认
qat.pt和quantized.bc哪一个是当前最稳定的精度基线。 -
先排除明显的用户侧问题,再用“快速判断”表定位问题更可能发生在哪一段。
-
如果是 export 问题,先看
pre_export,再看qat.export.pt与qat.bc。 -
如果是 convert 问题,先比较
qat.bc与quantized.bc,再做敏感度分析。 -
如果是 compile / 部署问题,先确认
quantized.bc正常,再回看输入输出处理和板端部署差异。 -
如果常规方法仍无法定位,再使用
bc_editor继续缩小范围。
如果您在排查过程中还不熟悉 model_check_result.txt、fx_graph.txt、compare_per_layer_out.txt、output_xxx_sensitive_ops.txt 等产物,建议继续阅读 调试产物解读 章节。
Export 一致性
当 qat.pt 正常,但 qat.bc 不符合预期时,通常应优先怀疑问题发生在 export 阶段。
这类问题最常见的来源包括:查表转定点引入误差、导出图与训练图不一致,以及 export 后某些算子的实现差异。
典型现象
-
qat.pt的评测精度和多帧可视化正常,但qat.bc异常。 -
qat.export.pt已经异常,说明问题很可能在pre_export这一步就开始出现。 -
qat.export.pt正常,但qat.bc异常,说明更可能是 export 图或 HBIR 表达引入的问题。
分析前提
-
qat.pt必须先eval,并切换到FakeQuantState.VALIDATION。 -
qat.pt、qat.export.pt和qat.bc比较时,应尽量保证输入内容一致。 -
如果 torch 和 bc 模型无法直接接受同一格式输入,也需要保证两边输入除格式外内容一致。
排查步骤
-
先看
qat.export.pt是否正常。也就是说,先不要直接比较
qat.pt和qat.bc,而是先用pre_export将qat.pt转成qat.export.pt,判断“查表转定点”这一步是否已经带来明显误差。-
如果
qat.export.pt已经异常,优先判断问题是否由查表转定点引入。 -
如果
qat.export.pt正常,但qat.bc异常,优先判断问题是否来自 export 图不一致或 HBIR 导出阶段。
-
-
如果
qat.export.pt已经异常,先定位是不是查表问题。此时建议使用
QuantAnalysis(qat_pt, qat_export_pt, "pre_export")做逐层对比和敏感度分析,优先找出是哪些查表算子带来了明显误差。
- 如果常规方法仍然无法缩小范围,可以继续用
pre_export做分段定位。
-
如果
qat.export.pt正常,但qat.bc异常,继续比较qat.export.pt和qat.bc。此时建议使用
QuantAnalysis(qat_export_pt, qat_bc, "export")做 badcase 定位和逐层对比,确认问题是否来自 export 图、HBIR 表达或个别算子导出实现差异。
-
如果怀疑导出图本身与训练图不一致,再回看 Prepare 产物。
尤其是存在
if deploy、动态分支、循环次数变化等情况时,建议结合fx_graph.txt和model_check_result.txt先确认图结构是否与预期一致。
使用工具
-
pre_export用于把 export 阶段拆成两段,先判断问题是否已经在查表转定点阶段出现。
-
QuantAnalysis用于 badcase 定位、逐层对比和敏感度分析。export 阶段最常见的两种用法是:
-
QuantAnalysis(qat_pt, qat_export_pt, "pre_export") -
QuantAnalysis(qat_export_pt, qat_bc, "export")
-
-
fx_graph.txt/model_check_result.txt用于辅助判断 export 前后的图结构和 Prepare 结果是否一致。
需要保留的产物
-
qat.export.pt -
qat.bc -
compare_per_layer_out.txt -
output_xxx_sensitive_ops.txt / .pt -
model_check_result.txt -
fx_graph.txt
如果仍无法判断问题所在,建议至少保留上述产物,以及对应 badcase,便于继续分析或向技术支持反馈。
Convert 一致性
当 qat.bc 正常,但 quantized.bc 不符合预期时,通常应优先怀疑问题发生在 convert 阶段。
这类问题的本质,是模型从伪量化表示进入真正定点表示后,某些算子的实现差异被放大了。
对于 J6E/M 平台,如果您主要遇到的是 convert 或部署阶段偏差,也可以结合高一致性 QAT 策略一起考虑。
它虽然需要在 prepare 之前设置,但主要作用仍然是降低 convert / 部署阶段偏差,因此我们放在这一节介绍方便您理解。
高一致性 QAT 策略
如果您当前的问题主要表现为:
-
qat.pt / qat.export.pt / qat.bc基本正常,但quantized.bc开始掉点。 -
已经基本确认问题不在查表转定点,而更像是 convert 前后的一致性偏差。
-
当前使用平台为 J6E/M,并且希望优先用更低成本的方式改善 convert 一致性。
那么高一致性策略通常值得您优先评估。
反过来说,如果问题主要发生在 pre_export 或 export 阶段,例如查表转定点本身已经引入明显误差,那么高一致性策略通常不会带来直接帮助,此时仍应优先回到 export 阶段继续分析。
-
由于 J6E/M 平台浮点算力有限,更容易遇到训练部署一致性问题,为解决此类问题,我们提供了高一致性 QAT 策略,此策略仅对用于 J6E/M 平台生效,其他的平台不推荐您使用。
-
使用前请确认
hbdk版本不低于4.4.2,plugin版本不低于3.1.2。 -
对于不重训的场景,只有 level 0 有效,level 1 / level 2 需要在设置后重新训练。
-
高一致性 QAT 策略对查表转定点无影响,主要影响 convert 前后的一致性。
高一致性 QAT 策略封装在 horizon_plugin_pytorch.qat_mode.ConsistencyStrategy 中,用法如下:
当前支持三个等级(0 - 2)的策略。等级越高,一致性越好,但 QAT 精度可能受到轻微影响,因此,我们并不建议一开始就直接使用最高等级。 我们推荐您优先尝试使用 level 1,在大多数情况下对 QAT 精度无影响,且对性能和一致性可以有正向收益。
下表中:
-
POT(Power Of Two)scale,可简单理解为 scale 取值被约束到 2 的幂次形式。
-
A_POT(activation_pot)表示 activation 使用 POT scale,而 weight 仍使用统计型 scale。
结合现有实现,可以先这样理解它们的差异:
| level | 主要特点 | 更适合什么场景 |
|---|---|---|
| 0 | 保持常规统计型 scale 策略,不开启高一致性算子路径,但会开启高精度 qpp,并关闭 requantize fuse。这里的高精度 qpp 可先理解为量化参数传播时尽量保留更高精度的中间结果,以减少参数传递过程中的附加误差。关闭 requantize fuse 则是避免重定点相关逻辑被提前融合进相邻算子,减少 convert 前后因融合方式不同带来的偏差 | 已经完成训练、不希望重训,但希望先尽量改善 convert 一致性的场景 |
| 1 | 将 compute_scale_strategy 切到 A_POT,也就是激活侧使用 POT scale、weight 侧仍保持统计型 scale。同时开启 resize / gridsample / mean / mod_centered 的高一致性路径,并关闭 requantize fuse。核心目的,是先把激活侧 scale 收敛到更接近 convert 行为的形式,减少激活 scale 抖动和边界变化带来的偏差 | J6E/M 上遇到 convert 一致性问题时,最推荐优先尝试的起点 |
| 2 | 将 compute_scale_strategy 进一步切到 POT,也就是 activation / weight 都使用 POT scale。同时保持 resize / gridsample / mean / mod_centered 的高一致性路径开启,并关闭 requantize fuse。和 level 1 相比,主要多出来的是 weight 侧也切到 POT scale。经验上这通常会进一步压低 Linear / Conv 在 convert 阶段残留的一个 scale 级别误差概率 | level 1 仍不能满足一致性要求时,继续提高一致性的方案 |
关于 POT / A_POT,还建议您先这样理解:
-
它们首先是为了让 scale 形式更接近 convert 侧的实际行为,因此主要作用在训练部署一致性上,而不是直接替代常规精度调优手段。
-
一致性改善并不等于数据集精度一定同步提升。是否真正带来收益,仍建议回到
quantized.bc / hbm的评测结果和 badcase 复现情况判断。 -
POT / A_POT也不应默认理解为性能优化开关。它们更偏向一致性策略,是否带来额外收益或代价,仍需结合实际模型和部署结果确认。
如果您只想先抓住这三档策略的核心区别,也可以简单理解为:level 0 主要是在不重训前提下,减少量化参数传播和 requantize 融合带来的额外偏差。level 1 主要是 activation 用 POT scale,weight 仍保持统计型 scale。level 2 则是在 level 1 基础上进一步把 weight 侧也切到 POT scale,并继续压低 Linear / Conv 等关键算子剩余的一致性误差。
如上表所示,实际上:
-
level 0 更像“不重训前提下的补救方案”。
-
level 1 更像“推荐优先尝试的常规方案”。
-
level 2 更像“在 level 1 基础上进一步提高一致性”的加强方案。
使用时还建议您注意下面几点:
-
如果当前模型原本没有启用高一致性策略,而您又不希望重新训练,那么只能尝试 level 0,在 prepare 模型前设置一致性策略等级为 0。
-
如果准备正式使用 level 1 / level 2,请在设置策略后重新执行后续训练流程,而不要只在已有 checkpoint 基础上直接套用。
-
即使启用了高一致性策略,最终仍建议回到
quantized.bc / hbm的结果做验证,而不是只看训练侧模型是否改善。
使用时,还可以将下面这些现象作为辅助参考:
-
在 level 1 下,convert 阶段的
Linear / Conv通常仍可能存在一个 scale 级别的误差,其他算子通常更容易对齐。 -
在 level 2 下,
Linear / Conv的这类误差概率通常会进一步下降到很低的水平。 -
对于
Linear / Conv,如果去掉 bias,在 level 2 下 convert 阶段通常更容易做到无误差或近似无误差。
这些现象更适合作为理解策略效果的辅助参考,而不是绝对判断标准。实际项目中,仍建议以数据集评测结果和 badcase 复现情况为准。
如果您希望进一步了解 level 0 / 1 / 2 在实现层面的具体差异,例如各级别分别调整了哪些 scale 策略、哪些高一致性开关以及哪些导出行为,建议结合当前版本源码继续确认。不同版本之间,这部分实现细节可能存在调整。
典型现象
-
qat.bc的评测精度或可视化结果正常,但quantized.bc异常。 -
qat.export.pt与qat.pt没有明显问题,但quantized.bc与前两者相比开始掉点。
分析前提
-
qat.bc本身应已经确认精度正常,否则不要直接进入 convert 排查。 -
比较
qat.bc和quantized.bc时,必须使用同一套输入和后处理。 -
建议先在数据集上稳定复现 convert 前后一致性问题,再开始 badcase 和逐层分析。
排查步骤
-
先确认
quantized.bc的异常是稳定可复现的。如果 convert 后的精度波动不稳定,或 badcase 不可复现,建议先回到数据集和验证流程,确保比较过程本身可靠。
-
对
qat.bc和quantized.bc做 badcase 定位与逐层对比。这是 convert 阶段最核心的一步。建议使用
QuantAnalysis(qat_bc, quantized_bc, "convert")先找 badcase,再看逐层对比结果。
-
再结合
qat.export.pt做敏感度分析。在 convert 阶段,敏感度分析通常仍然建议基于 torch 侧更易分析的
qat.export.pt来做,同时复用qat.bc与quantized.bc对比中找到的 badcase。
- 如果已经确认问题主要来自 convert,但常规逐层分析仍然无法缩小范围,再考虑使用更细粒度工具继续分段定位。
使用工具
-
QuantAnalysisconvert 阶段最常用的用法是:
QuantAnalysis(qat_bc, quantized_bc, "convert"):查 badcase、跑逐层对比QuantAnalysis(qat_export_pt, quantized_bc, "convert"):基于同一 badcase 跑敏感度分析
-
高一致性 QAT 策略
对 J6E/M 平台,如果您当前主要遇到的是 convert 前后一致性问题,可以优先评估是否需要使用高一致性策略降低 convert 阶段偏差。
-
bc_editor当常规分析无法定位问题时,可通过编辑 bc 模型,把部分算子退回 CPU 执行,进一步缩小 convert 问题范围。
需要保留的产物
-
quantized.bc -
compare_per_layer_out.txt -
abnormal_layer_advisor.txt -
output_xxx_sensitive_ops.txt / .pt -
badcase.txt或可稳定复现问题的输入样本
如果仍无法判断问题所在,建议至少保留上述产物,以及对应 badcase,便于继续分析或向技术支持反馈。
Compile / 部署一致性
当 quantized.bc 已经正常,但 hbm 或板端结果不符合预期时,通常应优先怀疑问题发生在 compile 或部署适配阶段。
这一阶段的问题,往往不再只是模型内部数值实现差异,还可能涉及输入输出处理、插入节点、前后处理适配和板端部署方式。
典型现象
-
quantized.bc精度正常,但hbm异常。 -
x86 上的
hbm结果与板端结果不一致。 -
插入前处理节点、删除首尾节点或板端接入后结果开始变差。
分析前提
-
进入 compile / 部署排查前,必须先确认
quantized.bc自身已经正常。 -
确保 compile 前后的输入输出定义、layout、前后处理以及 padding / 对齐策略保持一致。
-
如果板端结果异常,建议先区分是
hbm仿真就异常,还是仅板端接入异常。
排查步骤
-
先确认问题是否真的发生在 compile 之后。
也就是说,要先明确
quantized.bc是正常的。如果quantized.bc也异常,应回到 convert 阶段继续排查。 -
检查输入输出处理是否一致。
这一阶段最常见的问题,不是算子本身,而是输入输出形式、前后处理、插入节点、删除节点以及部署接口适配不一致。
-
如果涉及插入前处理节点、删除首尾节点或其他图修改,建议分别对修改前后结果做比较。
-
如果是板端异常但 x86 仿真正常,优先怀疑板端部署接入、数据准备或运行方式差异,而不是直接怀疑模型转换本身。
使用工具
-
hb_verifier或等效比对方式:用于比较 HBIR 与 HBM、x86 与板端结果之间的一致性。 -
部署侧日志、输入输出 dump、板端推理脚本:用于确认问题是否来自部署接入而非模型本身。
需要保留的产物
-
quantized.bc -
hbm -
compile 配置
-
板端输入输出样本
-
对应 badcase 的前后处理输入、输出和日志
如果仍无法判断问题所在,建议至少保留上述产物,以及对应 badcase,便于继续分析或向技术支持反馈。
常规分析仍无法定位时
如果您已经完成 badcase、逐层对比和敏感度分析,仍然无法判断 convert 阶段问题具体落在哪些算子上,可以继续使用 bc_editor 做分段定位。
bc_editor 位于 horizon_plugin_profiler/bc_editor/bc_editor.py,同一目录下通常会提供配置示例。
它的核心思路是:
-
先查看
qat.bc的文本表示,定位可疑算子的 HBIR 编号。 -
通过配置文件删除指定范围的 fake quant。
-
重新得到修改后的 bc,并再次 convert。
-
对比编辑前后的
quantized.bc表现,判断哪些算子退回 CPU 后能明显改善一致性。
示例如下:
对比编辑前后 quantized.bc 的结果,可以进一步看出哪些算子退回 CPU 后能明显提高一致性。