

ONNX 模型量化常见问题
以下问题按 模块准备&算子支持 / 模型转换 / 模型性能 / 模型精度 四个方向组织。若已有具体现象(例如 NaN、上板掉点、quant_config 不生效等),可先按下表快速定位到对应问答:
| 现象 | 可能原因 | 优先排查方向 | 详细问答 |
|---|---|---|---|
Calibrated Cosine / Quantized Cosine 列出现 NaN | 模型中 where 算子第二个输入为 -Inf、或校准数据经 concat / equal 传播产生全 0 tensor 导致校准阈值非法 | 先看 hb_compile.log 中 NaN 出现的节点位置,再回浮点模型可视化确认对应结构,换多组校准数据复现 | Calibrated Cosine 出现 NaN 的几种情况 |
| 某个 BPU 可支持算子出现在 CPU 上 | 算子处于模型首/尾部,未被主动量化或被动量化命中,或尾部 Conv 高精度输出导致后续算子回退 CPU | 先看 hb_compile.log 中该算子的 ON 列(CPU / BPU),结合主动量化 / 被动量化规则判断是否可通过 quant_config 强制上 BPU | 主动量化和被动量化,尾部 BPU 可加速算子运行在 CPU 上 |
input_batch 配置不生效 | input_shape 第一维不为 1,或原始 ONNX 模型本身不支持多 batch 推理 | 先确认 input_shape 第一维是否为 1,确认原始 onnx 是否本身可多 batch 推理 | 如何编译得到多 batch 模型 |
quant_config 配了但没生效 | 被工具因算子约束回退,Resize / GridSample 未显式回退到 int8,尾部 BPU 可加速算子被回退到 CPU,或主动 / 被动量化限制 | 先看 hb_compile.log 中相应算子的实际 Output Data Type,结合 quant_config 说明 章节的平台经验模板小节确认写法 | quant_config 配置未生效 |
| 上板性能不及预期 | 存在 CPU 算子,模型分段导致异构调度开销,或量化 / 反量化算子未融合进前后处理 | 先看 .html / .json 静态评估文件与板端 hrt_model_exec 实测,再看 hb_compile.log 中 CPU 算子分布 | 上板性能不及预期,模型分段的性能影响 |
上板精度掉点(quantized.bc 与 hbm 差距明显) | 板端输入准备 / 前后处理 / stride 对齐差异,跨平台输出类型差异,或存在移除输入/输出端节点场景未使用 quantized_removed_model.bc 对齐 | 先在 x86 侧用 hbm_infer 复现板端输出,再对照 ONNX 模型部署一致性分析 章节按阶段排查 | quantized.bc 精度正常但 hbm 精度掉点 |
| 多输入模型输入顺序发生变化 | 模型转换过程中会调整多输入的顺序,属正常现象 | 做精度一致性对齐时,通过 hb_model_info 查看 hbm 实际输入顺序,再按顺序喂数据 | 多输入模型输入顺序发生变化 |
模块准备&算子支持
如何准备地平线支持转换的浮点模型?
地平线 PTQ 浮点转换工具链支持 Caffe1.0 和 ONNX(10≤opset_version≤19 且 ir_version≤9)两种模型格式。ONNX 导出方式参考如下:
以上,模型可视化教程内的 ONNX 模型 opset_version、 ir_version 版本支持范围与当前略有差异,请以当前版本范围为准。
如何验证原始浮点 ONNX 模型的正确性?
工具链在转换模型时,会使用基于公版 ONNXRuntime 封装的接口实现模型的解析和前向,所以我们应该在使用工具链之前先检查原始浮点 ONNX 模型本身的合法性(即是否能够正常推理), 以及从训练框架导出 ONNX 的过程中是否引入了精度偏差。具体测试方式可参考:HBRuntime 推理库 章节。
如何修改模型的输入 layout?
J6 平台上,我们提供的工具不再支持转换过程中修改模型的输入layout格式,ONNX 模型在转换过程中会保持模型layout不改变。如有修改layout需求可以直接在导出onnx前修改模型完成layout的改变。
如需要从模型层面修改,建议使用如下方式实现:
-
在 DL 框架中增加 transpose,使其输入 layout 为 NHWC,并重新导出 ONNX 模型。
-
使用 onnx 库直接修改模型,参考如下:
关于算子约束中int32数据类型的支持说明
当前算子约束中有部分算子显示支持了int32,但是int32并不是通过quant_config中配置qtype来支持的,此处对int32支持的几种情况进行详细说明。
情况1:部分算子的输出支持量化到int32高精度
以Conv为例,J6E/M平台,当Conv算子是最后一个被量化的算子(如Conv是模型最后一个算子)时,那么为了保证模型精度,这个Conv的输出会默认被量化到int32。
情况2:BPU可以支持原始模型中输入本来就是int32的算子
以Mul为例,如果输入模型中某个Mul算子的输入就是int32的,那么工具不会处理这个算子即可以直接跑在BPU。
情况3:ArgMax/ArgMin算子
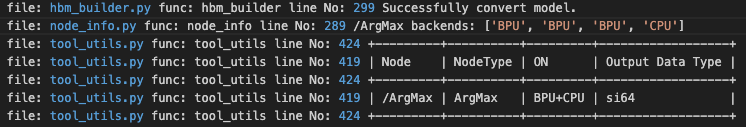
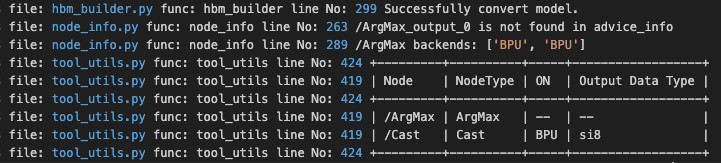
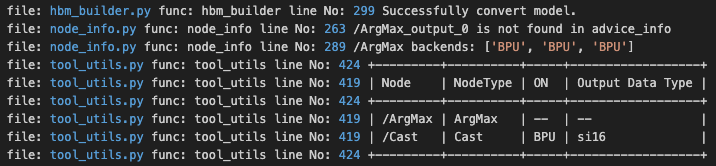
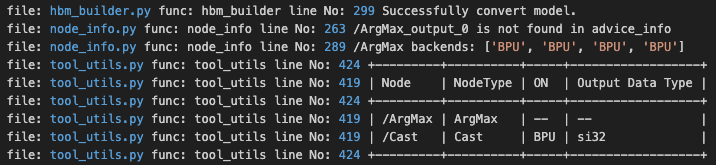
ArgMax/ArgMin算子在onnx的定义中仅支持int64输出,但是在算子约束中ArgMax/ArgMin的输出支持int8, int16, int32。 如果您想要上板时ArgMax/ArgMin的输出是int8, int16, int32,那么您需要自己在onnx模型中的ArgMax后面插入Cast算子。
这里具体Cast到哪个datatype,需要您根据模型中实际需要用到的数据精度来选择,避免因为Cast的datatype的bit太低导致精度出现损失,建议您插入Cast后,进行一次浮点模型精度的验证
示例
以ArgMax为例,说明是否在在ArgMax后面插入Cast的区别
不带Cast的ArgMax算子的部署情况
-
onnx导出代码
-
部署情况(以J6P为例)
如下图所示,通过log可以看到,这个ArgMax算子在上板时会用到CPU
在ArgMax后插入Cast的部署情况
-
onnx导出代码
-
部署情况(以J6P为例)
-
Cast到int8:如下图所示,通过log可以看到,这个ArgMax算子在上板时仅会用到BPU
-
Cast到int16:如下图所示,通过log可以看到,这个ArgMax算子在上板时仅会用到BPU
-
Cast到int32:如下图所示,通过log可以看到,这个ArgMax算子在上板时仅会用到BPU
-
模型转换
如何理解yaml文件中的编译器优化等级参数?
在模型转换的yaml配置文件中,编译参数组提供了optimize_level参数来选择模型编译的优化等级,可选范围为 O0~O2。其中:
-
O0 不做任何优化,编译速度最快,适合在模型转换功能验证、调试不同校准方式时使用。
-
O1 - O2 随着优化等级越高,编译优化时的搜索空间就会越大。
-
编译器的优化策略并不是算子粒度层面的,而是针对整个模型的全局优化。
如何编译得到多 batch 模型?
根据原模型种类,我们将分为动态输入模型和非动态输入模型来讨论这个问题。
-
input_batch参数仅在input_shape第一维为1的时候可以使用,(模型为多输入时,需要所有输入的input_shape第一维均为1),且此参数仅在原始onnx模型本身支持多batch推理时才能生效,该参数仅支持配置一个数值,模型为多输入时,配置后该值将作用于模型的所有输入。 -
每份校准数据shape大小,应和
input_shape的大小保持一致。
动态输入模型:如果原模型为动态输入模型时,比如,?x3x224x224(动态输入模型必须使用input_shape参数指定模型输入信息)。
-
当配置input_shape为1x3x224x224时,如果您想编译得到多batch的模型,可以使用
input_batch参数,此时每份校准数据shape大小为1x3x224x224。 -
当配置input_shape的第一维为大于1的整数时,原模型本身将会认定为多batch模型,将无法使用
input_batch参数,且需要注意每份校准数据shape大小。例如配置input_shape为4x3x224x224时,此时每份校准数据shape大小需要为4x3x224x224。
非动态输入模型:
-
当输入的input shape[0]为1时,可以使用
input_batch参数,每份校准数据shape大小与原模型shape保持一致。 -
当输入的input shape[0]不为1时,不支持使用
input_batch参数。
先看哪里
-
先看产物:确认原始 onnx 模型的
input_shape第一维是否为 1。 -
先看日志:
hb_compile.log中input_parameters info分组会打印实际生效的input_shape与input_batch。 -
先看专题:本页 如何编译得到多 batch 模型。
多输入模型在转换过程中,模型输入顺序发生变化,此种情况正常么?
此种情况是正常现象,多输入模型在转换过程中,模型输入顺序是有可能发生变化的。 可能发生的情况如下例所示:
-
原始浮点模型输入顺序:input1、input2、input3。
-
original.onnx模型输入顺序:input1、input2、input3。
-
quanti.bc模型输入顺序:input2、input1、input3。
-
hbm模型输入顺序:input3、input2、input1。
-
当您做精度一致性对齐时,请确保输入顺序是正确的,不然有可能会影响精度结果。
-
如果您想查看hbm模型输入的顺序,可以使用
hb_model_info指令来查看,input_parameters info分组中列出的输入顺序,即为hbm模型的输入顺序。
先看哪里
-
先看产物:
hbm模型本身。 -
先看日志:
hb_model_info输出的input_parameters info分组。 -
先看专题:本页 多输入模型输入顺序发生变化。
如何理解 ONNX 模型转换过程中的主动量化和被动量化?
在模型成功转换成hbm模型后,可能会出现发现仍然有个别op运行在CPU上的情况,但回头仔细对照工具链算子约束列表,明明该op是符合算子约束条件的,也就是理论上该算子应该成功运行在BPU上,为什么仍然是CPU计算呢?
针对此问题,您可参考 地平线官方社区文章,该文章对模型转换工具链中内部的量化原理与背后的逻辑进行了介绍,并针对问题提供了几种解决方法。
先看哪里
-
先看产物:
*_node_info.csv,查看目标算子的 CPU / BPU 分布与相似度。 -
先看日志:
hb_compile.log中该算子的ON列(CPU 或 BPU)。 -
先看专题:本页 主动量化和被动量化,尾部 BPU 可加速算子运行在 CPU 上。
如何理解 shape_inference_fail.onnx?
该模型只会在 ONNX 模型转换失败时产出,无特殊意义,可向地平线提供该模型和模型转换时的 log 文件进行 debug 分析。
如何理解optimized模型中算子发生变化?
为了提高模型的上板性能,模型转换有一个Optimizer模块,该模块会对模型进行一些图优化,以提升模型上板的性能。 Optimizer模块主要包括常量折叠、算子替换、算子属性/输入更改、算子融合、算子移动等功能。
Optimizer模块会导致模型的算子发生变化,该模块会对模型进行一些等价的图优化。
在转换流程中,hb_compile打印日志中Calibrated Cosine列出现nan的几种情况以及导致此类问题的原因?
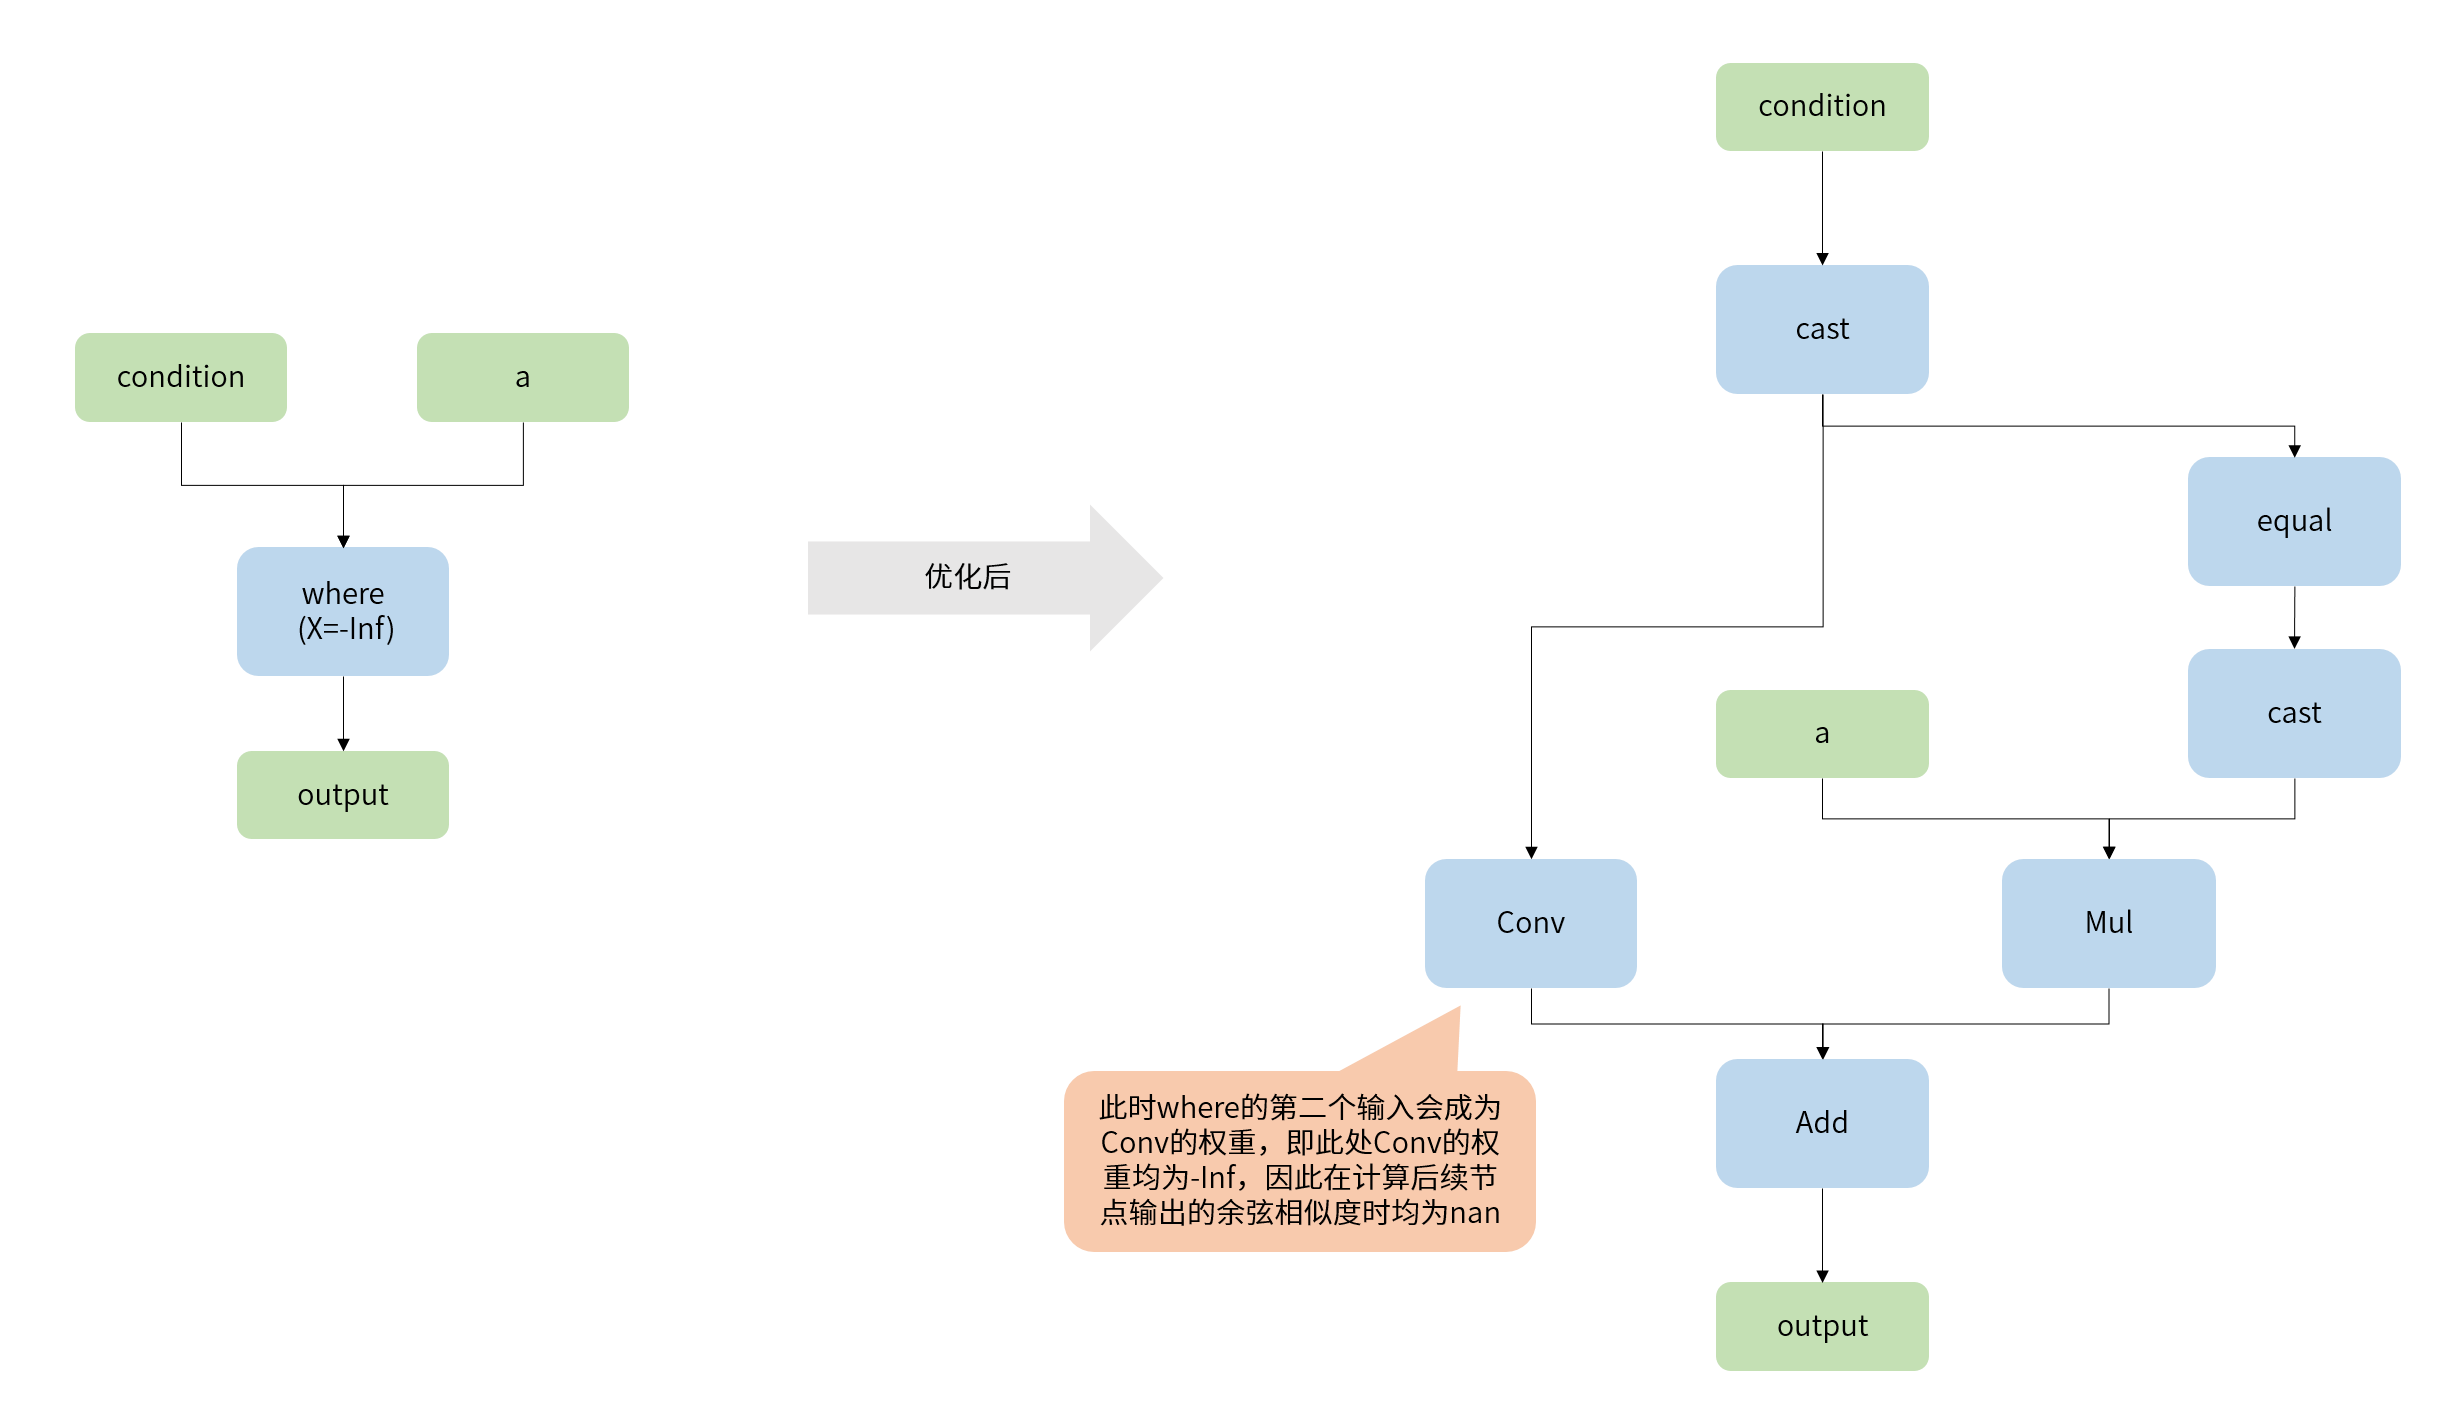
情况1:模型中where算子的第二个输入为-Inf
在转化过程中的优化阶段,为了能够保证where算子可以被量化,在优化阶段会将此算子拆解成多个可量化算子的组合。当 where 的第二个输入为 -Inf 时,会出现转换过程中出现nan的情况。具体原因如下:
情况2:模型中出现全 0 tensor
1). 由 concat 导致出现全0 tensor
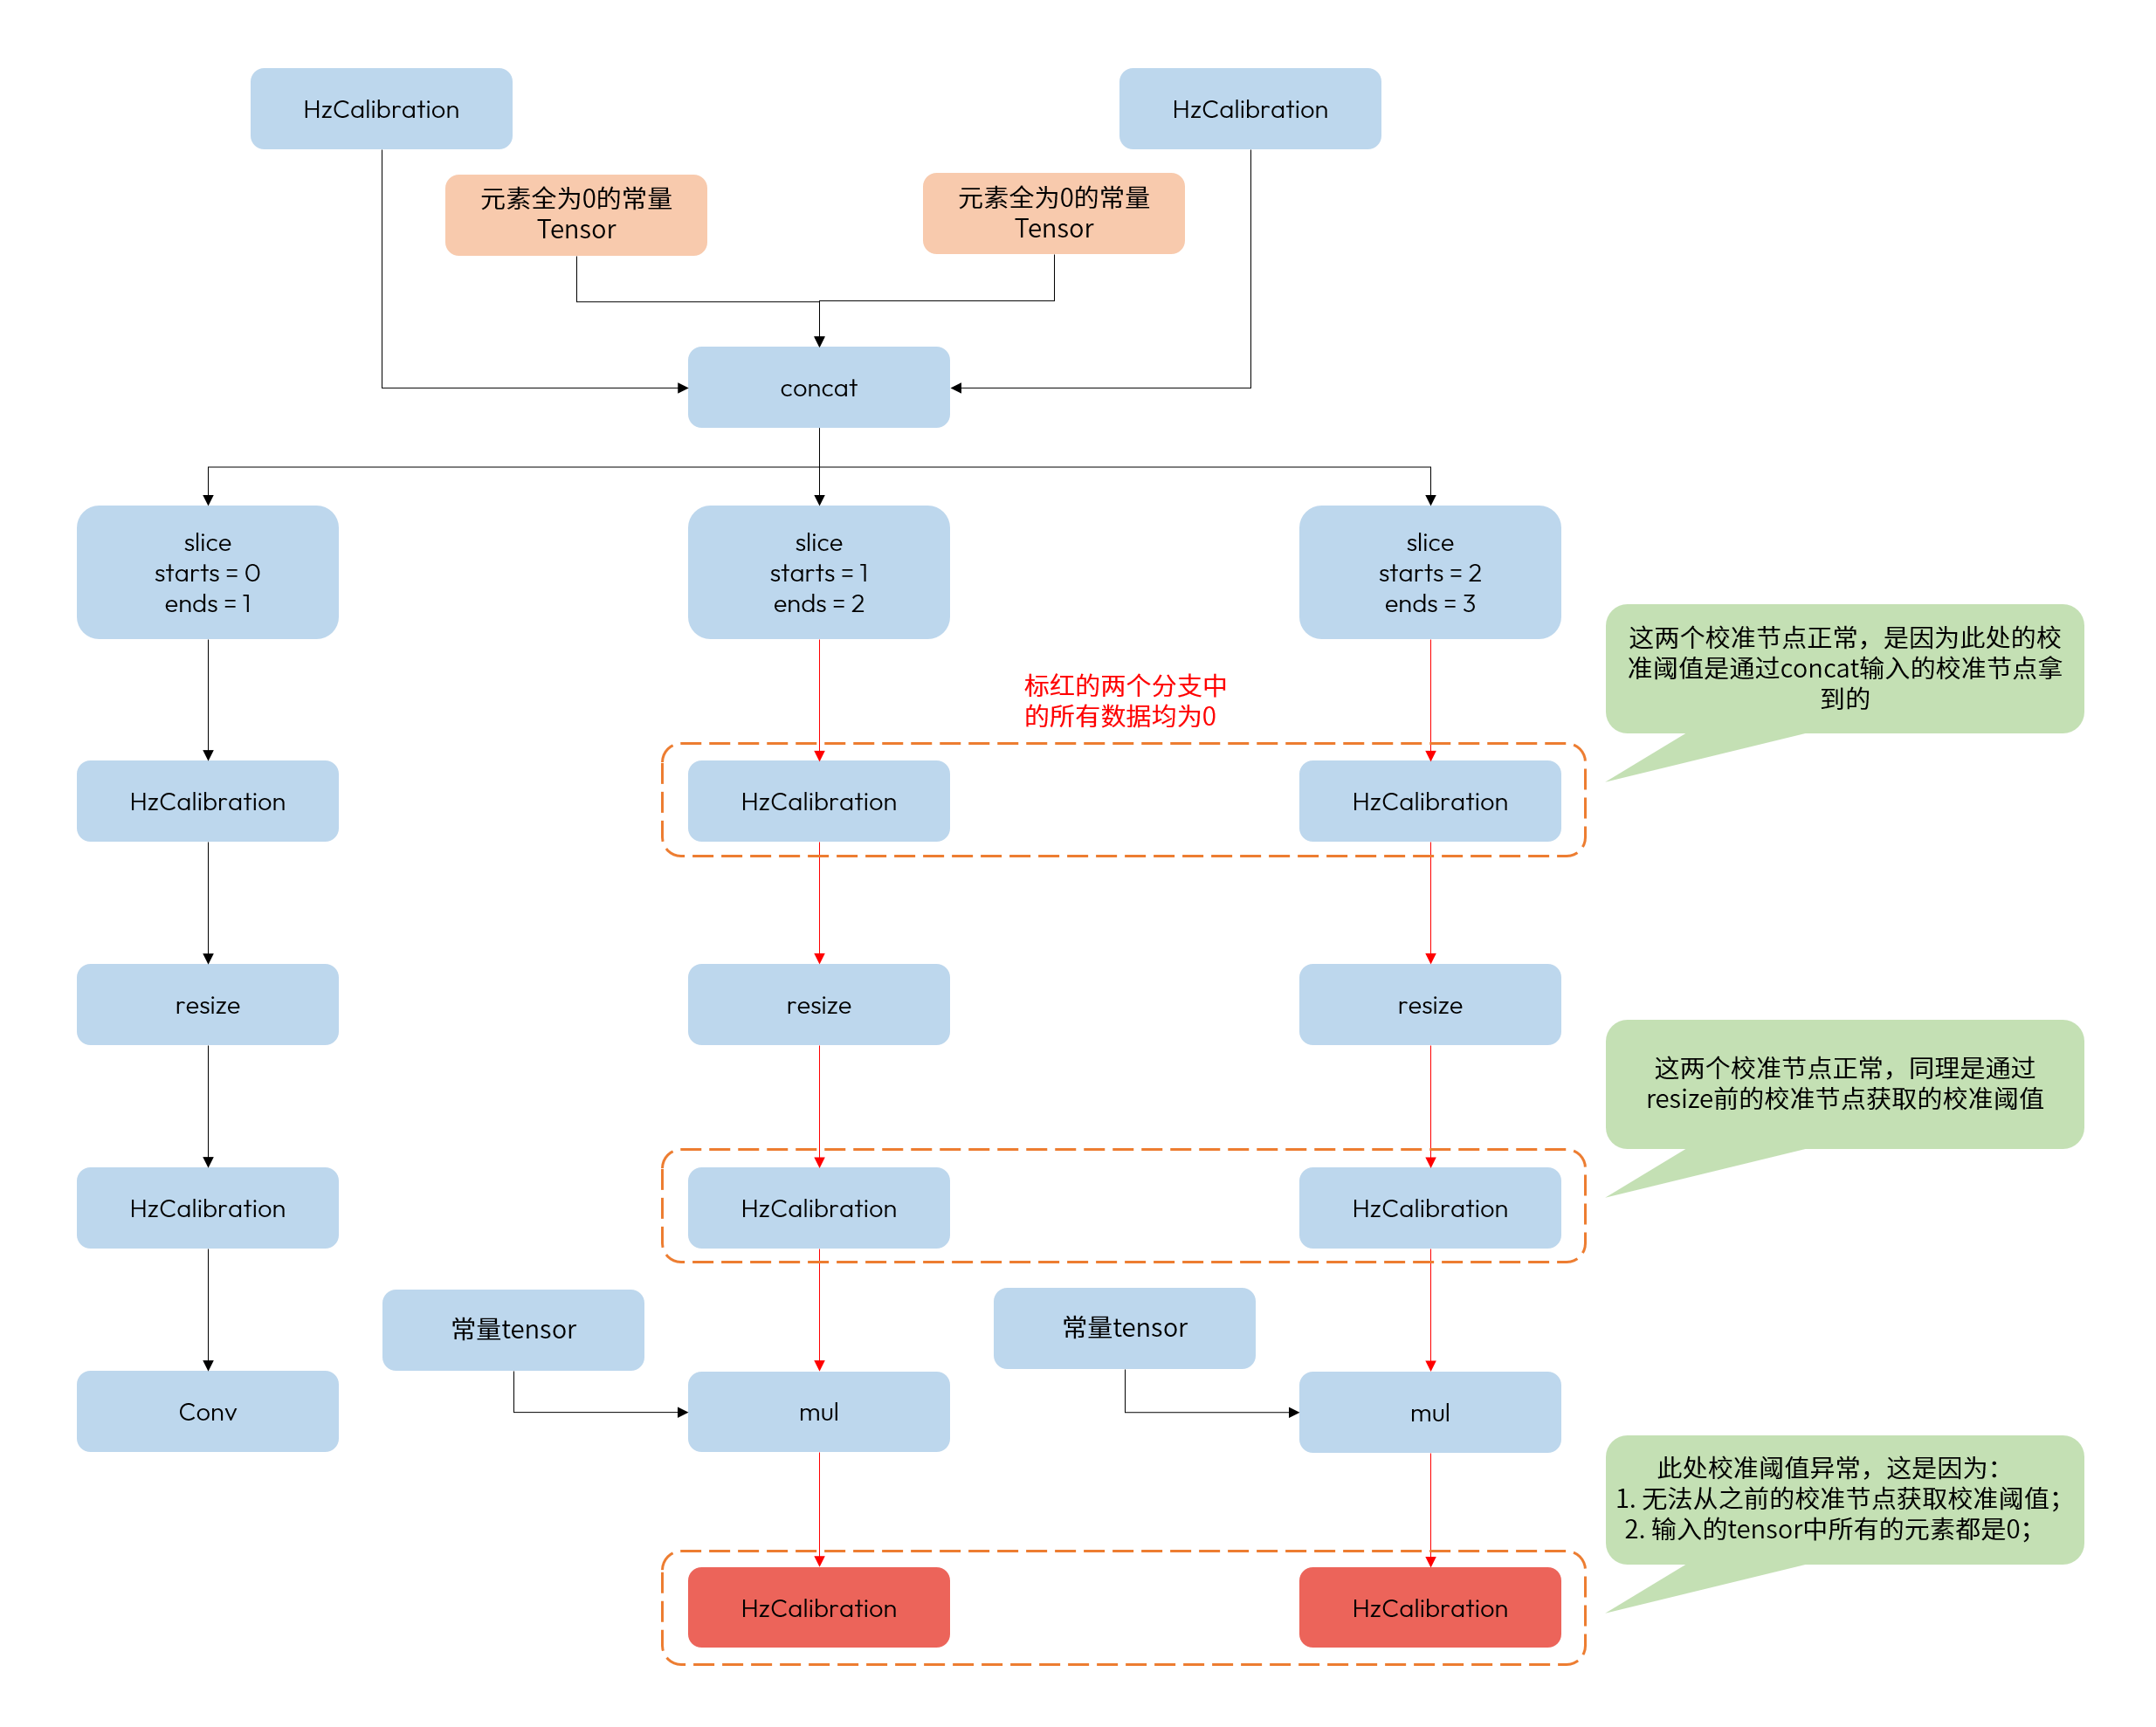
以上述结构为例,concat的两个输入为全0常量,因此在后续经过slice后的输出有可能出现某个分支中流动的数据均为0的情况,并且导致HzCalibration出现非法阈值(即:阈值为0)。
2). 由equal导致出现全0 tensor
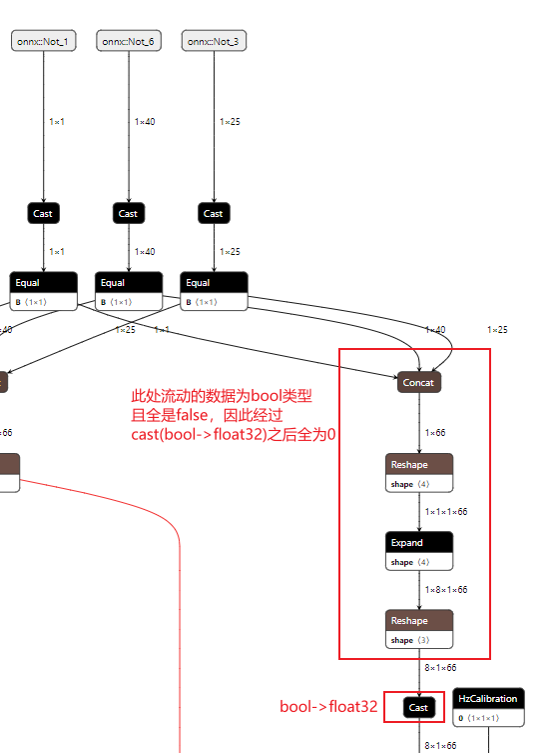
以上述结构为例,模型的输入onnx::Not_3为bool型tensor,在经过cast+equal之后,导致tensor中的数据均为false,在经过cast(bool -> float32)后,出现全0 tensor。
此种情况需要您尝试使用多组数据进行测试,进而排除由校准数据导致模型出现全0的可能。
先看哪里
-
先看产物:出现 NaN 时对应算子的浮点模型可视化视图(可用 Netron 打开
*_original_float_model.onnx)。 -
先看日志:
hb_compile.log中 NaN 出现的具体节点名称与上下文算子。 -
先看专题:本页 Calibrated Cosine 出现 NaN 的几种情况。
配置了 quant_config 中的 qtype 后没生效?
quant_config 中 qtype 未生效,通常与工具的算子约束、算子上下文强制约束有关,常见情况如下:
-
算子约束不支持配置的 dtype 或起步阶段更推荐用低精度:例如 Resize / GridSample 在 J6H/P 全 float16 场景下,起步阶段建议先从 int8 尝试(int8 上性能更好),建议显式配置这两个算子的
qtype为 int8。 -
尾部 BPU 可加速算子被回退到 CPU:模型尾部 Conv 默认以 int32 / float32 高精度输出,其后跟随的 BPU 可加速算子(例如 ReLU、Add 等)默认会回退到 CPU 上,如需强制上 BPU,可参考 尾部 BPU 可加速算子运行在 CPU 上。
-
主动 / 被动量化限制:部分非计算密集型算子(例如 Reshape、Transpose、Concat)需要依赖上下游算子的量化阈值才能被动量化,
quant_config单独配置这些算子的qtype不会生效。
排查建议:
-
先看
hb_compile.log中目标算子的Output Data Type列,确认工具最终判定的数据类型。 -
对照 算子约束列表 章节确认该算子在当前平台上支持的输入/输出数据类型组合。
-
参考 quant_config 说明 章节的平台经验模板小节,确认平台推荐的写法。
先看哪里
-
先看产物:
*_node_info.csv中目标算子的相似度与部署信息。 -
先看日志:
hb_compile.log中目标算子的ON/Output Data Type列。 -
先看专题:本页 quant_config 配置未生效,quant_config 说明 章节的平台经验模板小节。
模型性能
如何理解BPU加速和CPU计算两种形式?
-
BPU加速:是指模型在板端推理时,该算子可以通过BPU硬件进行量化加速。其中,大部分算子(如conv等)是硬件直接支持的。有些会被替换成其他算子实现加速(如gemm会被替换成conv),还有一些则依赖特定的上下文(如Reshape、Transpose需要前后均为BPU算子)才能被动量化。
-
CPU计算:对于模型中BPU硬件无法直接或间接加速的算子,工具链会将其放在CPU上计算,runtime预测库也会在模型推理时自动完成执行硬件的异构调度。
是否有硬件支持模型输入颜色空间转换?
BPU 支持常见模型输入格式间的转换(例如 nv12 -> rgb/bgr)和数据归一化,可以通过 yaml 文件进行配置。 具体请见 input_type_train、input_type_rt、mean_value、scale_value、std_value 等参数的说明。
如何理解编译器优化等级?
yaml 文件 optimize_level 参数可配置 O0~O2 的编译器优化等级,优化等级越高则搜索空间越大,通常耗时也会更多。优化等级并不会针对算子粒度层面进行一些确定的优化策略,大部分算子的优化与优化等级没关系(这些优化不耗时)。优化等级主要是对全局优化起作用,是结合整个模型进行的分析和优化。
如何处理模型首尾部的量化/反量化算子?
ONNX 模型量化过程中,工具链默认会在 featuremap 输入模型的首部插入量化算子来实现输入数据从 float32 到更低 bit 计算类型的映射,并在所有模型的尾部插入反量化算子来实现输出数据从低 bit 计算(若 BPU 以 conv 结尾则默认为 int32/float32 输出) 到 float32 的映射。而量化/反量化算子在 CPU 上的执行效率并不高,特别是在数据 shape 比较大的时候。
所以我们更建议通过将量化/反量化操作融合进前后处理,此种方式最为高效,具体说明请见:反量化节点的融合实现。
如何使用 unitconv 算子优化模型性能?
模型中的一个算子能运行在 BPU 上,除了其本身应满足 BPU 支持条件外,还需要能在校准时找到它的量化阈值。 而部分非计算密集型算子(如 concat,reshape 等)的量化阈值会依赖于上下游算子的 featuremap Tensor。 因此,若这些算子在模型首尾处就会默认跑在 CPU 上。 此时若想追求更高效的性能,可以在该算子前/后插入 unitconv 来引入新的量化阈值统计,进而将其量化在 BPU 上。 具体说明可见:unit_conv使用说明(用于优化模型性能) 。
但需要注意的是,这种方法有可能会引入一定的量化损失。 以 conv+reshape+concat 结构输出的模型为例, 工具链默认 conv 会以 int32/float32 高精度输出,反量化至 float32 后再送给 CPU 上的 reshape 和 concat。 若在 concat 之后插入 unitconv,则整个结构都将以 int8 低精度运行在 BPU 上, 此时虽然最后的 unitconv 还能以 int32/float32 高精度输出,但前面 conv 输出的精度压缩已经引入了一定的量化损失。 所以,是否插入 unitconv 来优化性能还请综合考虑。
如何理解模型分段的性能影响?
当模型在BPU算子中间存在不能加速的CPU算子时,在BPU算子和CPU算子之间切换计算时会引入一定的性能损耗,具体包括两方面:
-
CPU算子性能远低于BPU算子。
-
CPU和BPU之间的异构调度还会引入量化、反量化算子(运行在CPU上),且因为内部计算需要遍历数据,所以其耗时会与shape大小成正比。
地平线建议您尽量选择BPU算子搭建模型,以获取更好的性能表现。
上板性能不及预期该如何排查?
拿到 hbm 后板端性能不达预期,通常从以下几个方向排查:
-
是否存在 CPU 算子:CPU 算子性能远低于 BPU 算子,且 CPU / BPU 之间的异构调度还会引入量化 / 反量化算子。可先看
hb_compile.log与.html静态评估文件确认 CPU 算子分布,参考 模型分段的性能影响。 -
模型分段是否过多:CPU 与 BPU 之间频繁切换会显著拉低性能。参考 模型分段的性能影响,若为尾部 BPU 可加速算子被回退到 CPU,参考 尾部 BPU 可加速算子运行在 CPU 上 判断是否可通过
quant_config强制上 BPU。 -
量化 / 反量化算子是否未融合进前后处理:可参考 如何处理模型首尾部的量化/反量化算子 与 反量化节点的融合实现 融合进前后处理。
-
静态预估与板端实测是否一致:
.html/.json静态评估文件反映的是 BPU 部分的性能上限,而板端hrt_model_exec实测受输入准备、后处理等影响。两者差距较大时,请优先检查板端输入准备与前后处理耗时。
如需进一步调优,请参考 性能调优指导 章节。
先看哪里
-
先看产物:
.html/.json静态评估文件、*_node_info.csv。 -
先看日志:
hb_compile.log中 CPU 算子分布,板端hrt_model_exec实测输出。
模型精度
如何正确处理模型的校准数据?
ONNX 模型校准数据的准备请参考 数据准备-模型校准集准备 章节。另外,对于 featuremap 输入的模型,请自行完成数据的预处理,并通过 numpy.save 接口保存为所需输入类型的 npy文件。
如何 dump 模型中间层输出?
在模型转换阶段,yaml 文件中的 debug_mode 参数如果配置了 dump_all_layers_output,则会为每个卷积和矩阵乘算子增加一个反量化输出节点,它会显著的降低模型上板后的性能。
其中,output_nodes 参数可以指定模型中的任意节点为输出节点,更利于我们调试调优。 此外,还可以使用 hb_verifier 工具对比定点模型 quantized_model.bc 和上板 hbm 模型的一致性。
在板端部署阶段,hrt_model_exec 工具也支持以 bin 或 txt 的格式保存节点输出(包括用 output_nodes 参数指定的节点),具体使用方式可参考: hrt_model_exec工具介绍 。
如何理解模型尾部部分BPU可加速算子运行在CPU上?
首先,我们需要理解以下两个概念:
-
目前只在模型尾部支持Conv算子以int32/float32高精度输出。
-
通常情况下,模型转换会在optimization阶段将Conv与其后的BN和ReLU/ReLU6融合在一起进行计算。但由于BPU硬件本身限制,在模型尾部以int32/float32高精度输出的Conv却并不支持算子融合。
所以如果模型以Conv+ReLU/ReLU6结尾,那么为了保证量化模型的整体精度,Conv会默认以int32/float32高精度输出,ReLU/ReLU6则会跑在CPU上。同理,其他尾部可加速算子运行在CPU上也都是默认精度优先的选择。不过,地平线支持在yaml文件通过配置 quant_config 将这些算子运行在BPU上,从而获取更好的性能表现,但会引入一定的精度损失。
先看哪里
-
先看产物:
*_node_info.csv中尾部算子的部署分布与相似度。 -
先看日志:
hb_compile.log中尾部算子的ON/Output Data Type列。 -
先看专题:本页 尾部 BPU 可加速算子运行在 CPU 上,quant_config 说明 章节的平台经验模板小节。
quantized.bc 精度正常但 hbm 精度掉点?
quantized.bc 与 hbm 精度理论一致(含浮点算子模型的 bit 对齐特殊情况参考 部署一致性分析 章节的说明)。若 quantized.bc 数据集精度正常,但 hbm 精度出现明显掉点,通常应优先排查如下方向:
-
板端输入准备是否与
quantized.bc输入准备一致:input_type_rt到input_type_train的色彩转换、mean / scale 处理已固化到quantized.bc,板端输入准备需要与之匹配。 -
板端前后处理是否与开发机精度评测一致:例如后处理阈值、NMS 参数、归一化方式等未对齐。
-
是否为跨平台输出类型差异:J6E/M 尾部高精度算子输出类型为 int32,J6B/H/P 尾部高精度算子输出类型为 fp32。板端后处理代码若未按平台适配,会呈现为精度差异。
-
是否为 stride 对齐差异:J6H/P 上 nv12 输入需满足 stride 64 对齐,与 J6E/M/B 的 stride 32 对齐不同。板端输入未按平台对齐时,
hbm输出与quantized.bc会出现不一致。 -
是否存在移除输入/输出端节点场景:模型量化过程中如存在移除输入/输出端节点,一致性对比应使用
quantized_removed_model.bc与hbm对齐,而不是quantized_model.bc。
排查建议:先在 x86 侧用 hbm_infer 复现板端输出,与 quantized.bc 比对,排除板端环境差异,再按 ONNX 模型部署一致性分析 章节按阶段深入排查。
先看哪里
-
先看产物:
quantized.bc(或quantized_removed_model.bc)、hbm、板端hrt_model_exec输出、x86 侧hbm_infer复现输出。 -
先看日志:
hb_compile.log,板端后处理与hbm_infer输出对比结果。 -
先看专题:本页 quantized.bc 精度正常但 hbm 精度掉点,ONNX 模型部署一致性分析 章节。