

PyTorch 模型精度调优工具
由于浮点转定点过程中存在误差,当您在使用量化训练工具时,难免会碰到量化模型精度掉点问题。通常来说,造成掉点的原因有:
-
原有浮点模型不利于量化,如存在共享 op 或共享结构。
-
QAT 网络结构或配置异常,如模型中存在没有 fuse 的 pattern,没有设置高精度输出等。
-
某些算子对量化比较敏感,该算子的量化误差在前向传播过程中逐层累积,最终导致模型输出误差较大。
针对上述情况,量化训练工具提供了精度调优工具来帮助您快速定位并解决精度问题,主要包括如下:
-
模型结构检查:检查模型中是否存在共享 op、没有 fuse 的 pattern 或者不符合预期的量化配置。
-
使用 QuantAnalysis 类 自动比对分析两个模型:通过对比定位到量化模型中异常算子或者量化敏感 op。
-
使用ModelProfiler 类 和 HbirModelProfiler 类 获得模型中每一个 op 的数值特征信息:获取的信息包括输入输出的最大最小值等。这两个类的功能完全一致,区别在于 HbirModelProfiler 仅接受 qat hbir 模型作为输入。通常您无需手动调用该模块,可以直接通过 QuantAnalysis.run 来获得两个模型的数值信息。
快速上手
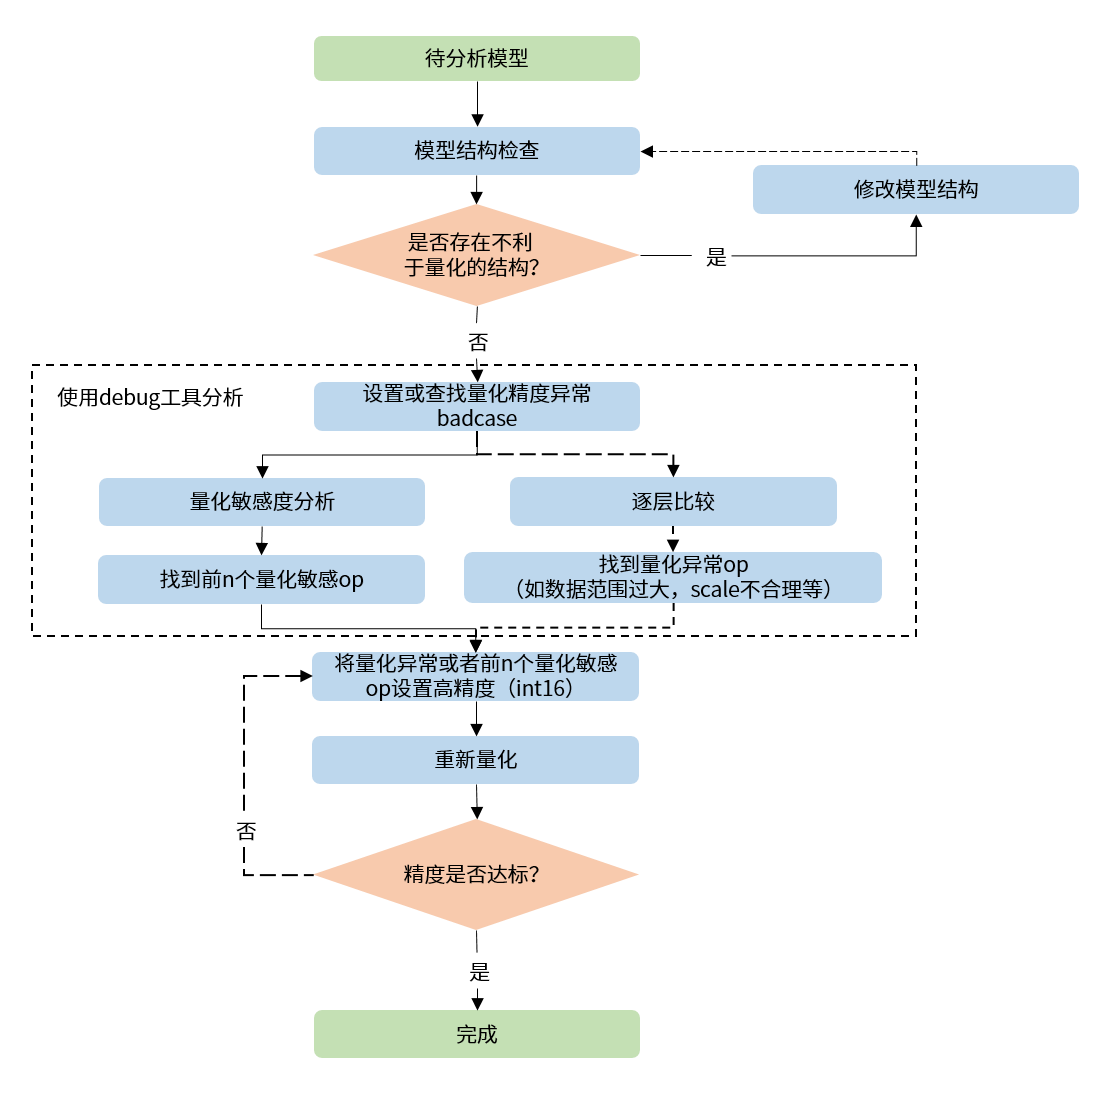
当碰到量化模型精度掉点问题时,我们推荐按照如下的流程使用精度调优工具。
-
检查模型中是否存在不利于量化的结构或者异常配置。
-
使用 QuantAnalysis 模块进行分析,具体步骤如下:
1). 找到一个基准模型和待分析模型输出相差最大的那个输入(即bad case)作为模型的输入。
2). 进行量化敏感度分析,目前的经验是 L1 敏感度排序前 n 个通常为量化敏感 op(不同的模型 n 的数值不一样,因此暂无自动确定的方法,需要手动尝试,如前 10 个,20 个...)。将量化敏感 op 设置高精度量化(如 int16 量化),重新进行量化流程。
3). 或者逐层比较两个模型的输入输出等信息,检查是否存在数据范围过大或者 scale 不合理等量化异常的 op,如某些具有物理含义的 op 应设置固定 scale。
-
当您碰到部署一致性问题时,QuantAnalysis 模块也支持分析 hbir 模型,接口使用和分析流程可以参考 部署一致性分析说明 章节。
整体的流程图如下:
一个完整的例子如下:
基于 loss metric 的推荐流程
上面的快速上手使用的是默认的 Metric.ATOL,它衡量的是单个 tensor 上的绝对误差。对于多输出网络,"某个 head 输出 ATOL 大" 和 "任务精度掉点" 之间往往没有直接对应关系。
因此,我们推荐您优先注册一个与最终任务目标一致的自定义 loss metric,并围绕这个 loss 做 debug。这样可以直接围绕任务目标定位问题,而不是只看某个输出上的局部误差。
两种常见的 loss metric 写法
1. 直接使用真实 GT 计算 loss
让模型的输出里额外携带真实 GT,然后在 metric 内部从 output1 中拆出 GT,再和 output2 中对应的量化预测结果计算 loss。
2. 先用浮点模型输出构造 pseudo GT,再计算 loss
根据 output1 中的浮点预测结果构造 pseudo GT,再用它和 output2 中的量化预测结果计算 loss。
怎么选:
-
如果您有可靠的 GT,并且更关心任务精度(精度调优),用「真实 GT loss」。
-
如果您没有 GT,或者当前目标是定位量化引入的误差(一致性分析或精度调优),用「浮点构造 pseudo GT 的 loss」。
推荐流程
-
先通过
Metric.register注册一个与任务目标一致的自定义 loss metric。 -
初始化
QuantAnalysis,并将该 loss metric 加入metric_list。 -
用
auto_find_bad_case(..., topk=k)自动搜索 badcase,k可以按照计算资源设置大一些。 -
调用
run(metric=loss_metric)采集最差 loss badcase 的逐层信息。 -
调用
compare_per_layer查看逐层误差。 -
调用
sensitivity(metric=loss_metric, use_sensitivity_v2=True)继续定位对最终 loss 影响最大的敏感算子。 -
若希望继续验证某个 case 升精度的收益,在完成 sensitivity v2 分析后,可调用
tune_bad_case验证精度收益。
使用 scope="all" 的 metric 时,模型的输出会作为一个整体计算,此时输出名固定为 all,因此 tune_bad_case 的 outputs_config 中直接使用 "all" 作为 key,产出物也会命名为 output_all_case_{index}_sensitive_ops.*。
如果当前任务暂时没有合适的自定义 loss,也可以先使用默认的 Metric.ATOL 启动分析;但对于多输出网络,仍然更推荐优先注册与最终任务一致的 loss metric。
多机多卡
QuantAnalysis 工具已支持多机多卡。若您已有 torch.nn.parallel.DistributedDataParallel 构建的训练环境,您只需将 train 函数替换成示例中的 quant_analysis 函数即可。
执行命令:
API Reference
模型结构检查
检查 calibration/qat 模型中是否存在不利于量化的结构以及量化 qconfig 配置是否符合预期。
参数
-
model: 待检查模型。
-
example_inputs: 模型输入。
-
save_results: 是否将检查结果保存到 txt 文件。默认 False。
-
out_dir: 结果文件 'model_check_result.txt' 的保存路径。默认空,保存到 .model_check_results/ 目录下。
输出
-
屏幕输出:检查出的异常层。
-
model_check_result.txt:在 save_results = True 时生成。主要由 5 部分组成:
1). 未 fuse 的 pattern。
2). 每个 module 的调用次数。正常每个 op 仅调用 1 次,0 表示未被调用,超过 1 次则表示被共享了多次。未调用或者共享多次的会有异常提示。
3). 每个 op 输出的 qconfig 配置。
4). 每个 op weight(如果有的话)的 qconfig 配置。
5). 异常 qconfig 提示(如果有的话)。
prepare 接口已集成该检查。请您关注此接口输出的检查结果,并根据检查结果对模型做针对性的调整。
QuantAnalysis 类
QuantAnalysis 类可以自动寻找两个模型输出最大的 bad case,并以此作为输入,逐层比较两个模型的输出。此外,QuantAnalysis 类还提供计算敏感度功能,您可以尝试将敏感度排名 topk 的节点设置高精度,如 int16 量化,来提升量化模型精度。
参数
-
baseline_model: 基准模型(高精度)。
-
analysis_model:待分析的模型(精度掉点)。
-
analysis_model_type: 待分析的模型类型。支持输入:
-
fake_quant:支持以下两种情况:
-
待分析的模型可以是精度掉点的 calibration 模型,此时基准模型可以是原始浮点模型或者一个精度达标的 int8/int16 混合配置的 calibration 模型。
-
待分析的模型是精度掉点的定点 hbir 模型,基准模型是对应的伪量化 hbir 模型。
-
-
pre_export:待分析的模型是查表转定点的伪量化模型,基准模型是对应的原始伪量化模型。
-
export:待分析的模型是伪量化 hbir 模型,基准模型是对应的查表转定点的伪量化模型。
-
convert:待分析的模型是定点 hbir 模型,基准模型是对应的查表转定点的伪量化模型。
-
-
device_ids:对比分析时模型运行的 GPU 设备 index,仅支持单 GPU,多机/多卡请参考多机多卡章节。
-
post_process:模型后处理。
-
out_dir:指定比较结果的输出目录。默认
./horizon_quant_analysis。 -
metric_list:参与比较的 metric 列表。默认
[Metric.L1, Metric.COSINE, Metric.ATOL]。可选的 metric 见 Metric 说明。
-
由于 QAT 训练会改变模型 weight 分布,通常情况下,我们不建议您将浮点或 calibration 模型和 qat 模型做对比。
-
hbir 模型不支持敏感度计算,若您对比的是两个 hbir 模型,请勿调用 sensitivity 接口。
Metric 说明
metric_list、run、sensitivity 等接口中使用的 metric 均来自 horizon_plugin_profiler.utils.entities.Metric。当前内置的 metric 如下:
若内置 metric 无法满足需求,也可以通过 Metric.register 注册自定义 metric。注册后的 metric 可用于查找 badcase、敏感度计算等所有功能。
参数
-
name:metric 名称,用于展示和索引,不能与已有 metric 重名。注册后可通过
Metric.{name}或Metric.get_metric(name)访问。 -
ascending:指标排序方向。
True表示值越大精度越好(如 COSINE、SQNR),False表示值越大精度越差(如 L1、ATOL)。 -
scope:定义 metric 作用在单个 tensor 上,还是作用在整个模型输出结构上。
-
"pertensor":对每个 tensor 输出单独计算。工具会展开模型输出中的 leaf tensor,并使用0、1、key等名称记录输出。 -
"all":对整个模型输出结构计算一个整体分数。适用于输出结构复杂、希望用单个总分衡量整体误差的场景,最常见的就是 loss。此时输出名固定为all。
-
其中 output1 和 output2 分别来自 baseline_model 和 analysis_model,但它们的粒度由 scope 决定:
-
当
scope="all"时,output1/output2是两侧完整的输出结构。 -
当
scope="pertensor"时,工具会先把输出展开成 tensor leaf,再逐个调用自定义函数,因此output1/output2只是单个 tensor。
对于多输出网络,我们更推荐您注册一个与最终任务目标一致的 loss metric,并围绕它做 debug,而不是只看某个输出上的局部误差。具体原因和推荐流程见 基于 loss metric 的推荐流程 章节。
该类中各个 method 如下:
auto_find_bad_case
自动寻找导致两个模型输出最差的 badcase。
参数
-
data_generator:dataloader 或者一个自定义的迭代器,每次迭代产生一个数据。
-
num_steps:迭代 steps 次数。
-
cached_attrs:作为模型输入的某些属性。通常在时序模型中使用,如运行第二帧时,将第一帧的某些结果作为输入。
-
dump_in_run: 是否在运行过程中保存 badcase。为 True 时边找边写磁盘,速度较慢但没有 OOM 风险;为 False 时先在内存中保存、结束时统一落盘,速度较快但可能占用较多内存。多机多卡环境下强制为 True,单机单卡默认 False。
-
topk:每个输出、每种 metric 各保留多少个 badcase。默认 1。推荐设置
topk > 1,保留多个 badcase,再结合后续的sensitivity(use_sensitivity_v2=True)交叉验证。很多模型的问题并不只集中在单个最差样本上,只看 top-1 容易把视野锁死在某一个局部异常上,导致后续敏感度分析给出的结论不稳定。
auto_find_bad_case 函数遍历传入的 data_generator,运行基准模型和待分析模型,计算每个输出在初始化时 metric_list 指定的各个 metric 上的比较结果,并找到在各个 metric 上比较结果最差的 topk 个 badcase 输入。
旧版本中的 metric、device、custom_metric_func 和 custom_metric_order_seq 参数均已废弃。传入这些参数不会报错,但不再生效:
-
metric:badcase 不再在查找阶段按单一 metric 筛选,而是对metric_list中的每个 metric 各保留一份结果。选择使用哪个 metric 的 badcase,改为在run/sensitivity中通过metric参数指定。 -
device:改为在QuantAnalysis初始化时通过device_ids指定。 -
custom_metric_func/custom_metric_order_seq:自定义 metric 改为通过Metric.register注册,再传入初始化时的metric_list,详见 Metric 说明。
输出
-
badcase_report.html:以 HTML 页面形式展示 badcase 报告,包括以下内容:
-
每个输出在各 metric 下的 topk badcase 索引及对应 metric 值的表格。
-
每个输出在各 metric 下所有 case 的统计信息(平均值、最差值)。
-
每个输出在各 metric 下 topk badcase 的统计信息(平均值、最差值)。
-
每个输出在各 metric 下 badcase 误差的分布直方图及百分位信息(如 99%、99.9%、99.99%)。
-
-
all_badcase_info.pt:保存的 BadCaseReport 对象,包含完整的 badcase 信息,可通过
torch.load加载。 -
badcase 文件夹:该目录下保存了 badcase_report.html 中显示的各个 index 的输入,如
0.pt,16.pt等。
返回值
BadCaseReport 对象,同时也会保存在 self.badcase_report 中。
set_bad_case
手动设置 badcase。
通常情况下,我们建议您通过 auto_find_bad_case 函数寻找 badcase。若手动设置的 badcase 非真正的 badcase,分析工具很难找出量化敏感层。
参数
-
data: badcase 输入。
-
baseline_model_cached_attr:基准模型的 cached_attrs。
-
analysis_model_cached_attr:待分析模型的 cached_attrs。
load_bad_case
加载已保存的 badcase 报告。
参数
- path:默认 None,直接从初始化时指定的
out_dir目录中加载all_badcase_info.pt。也可以传入一个本地目录,或者一个 http/https 链接(如集群上的产物路径),此时工具会先把该目录下的all_badcase_info.pt、badcase目录和badcase_report.html拷贝/下载到out_dir,再从out_dir加载。多机多卡场景下仅 rank 0 负责拷贝/下载,其余 rank 在 barrier 处等待后从本地加载。
该接口常用于复用一次已经跑完的 badcase 查找结果。例如在 convert 一致性分析中,先用 QuantAnalysis(qat_bc, quantized_bc, "convert") 找到 badcase,再用 QuantAnalysis(qat_export_pt, quantized_bc, "convert") 配合 load_bad_case() 基于同一个 badcase 跑敏感度分析。
set_model_profiler_dir
手动指定 model_profiler 的输出保存路径。
某些情况下,在 QuantAnalysis 初始化之前,ModelProfiler 就已定义并运行,此时可以直接指定已有的 ModelProfiler 路径,跳过 QuantAnalysis 的 run 步骤,直接比较两个模型的输出。
参数
-
baseline_model_profiler_path:基准模型的 profiler 路径。
-
analysis_model_profiler_path:待分析模型的 profiler 路径。
run
运行两个模型并分别保存模型中每一层的结果。
参数
-
device:该参数已废弃。通过 QuantAnalysis 初始化时的
device_ids指定 GPU。 -
index:输入数据在 data_generator 中的 index。指定后将直接使用该 index 对应的 badcase,不再按 metric 选择。不能与
metric同时指定。 -
run_baseline_model:是否运行基准模型。默认 True。
-
run_analysis_model:是否运行待分析模型。默认 True。
-
metric:使用哪个 metric 挑选出的 badcase 作为输入。默认 None,等价于
Metric.ATOL。 -
run_on_cpu:是否强制在 CPU 上运行模型。默认 False。当
analysis_model_type为export或convert时,工具会自动使用 CPU,因为 hbir 模型与 torch CPU 结果对齐更好,与 torch CUDA 可能存在较大差异,用 CPU 推理得到的单算子误差更准确。 -
out_name:只在指定的某个输出上挑选 badcase。默认 None,即在所有输出中挑选最差的 badcase。仅在未指定
index时生效。
仅支持 auto_find_bad_case 找到并在 badcase_report.html 中显示的 index 作为 index 参数输入。
分析统计信息
在 run 接口被调用后,baseline_model 和 analysis_model 会使用 badcase 进行推理,并将模型每一层的输入输出保存在输出路径的 op_infos 文件夹下。您可以使用 torch.load 加载 opinfo 文件,可以得到算子的输入输出。使用 matplotlib 可以绘制对应的数值分布图。
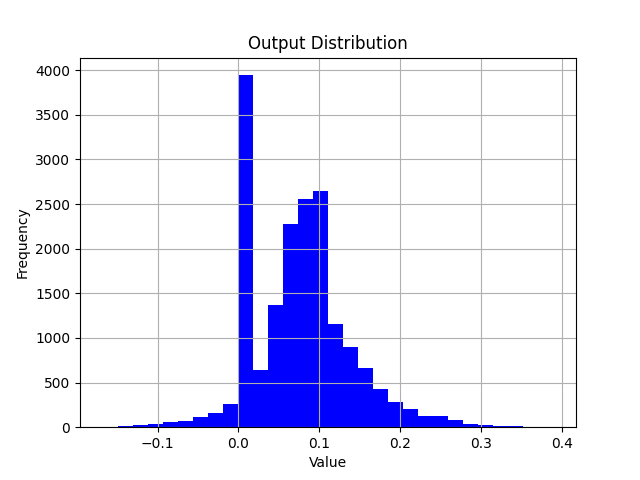
在分析单算子误差时,可以构造只包含一个算子的模型,将 opinfo 中的输入送入模型,对比模型输出和 opinfo 输出的差异,绘制散点图或直方图。
compare_per_layer
比较两个模型中每一层的结果。
参数
-
prefixes:指定 op 名字的前缀。
-
types:op 类型。
通常您无需指定 prefixes 和 types 参数。若您基于一些先验经验,想跳过某些确定的、量化影响较小 op 的比较,或想节省时间,您可以通过两个参数,指定比较某些 op 或者某类 op。
输出
-
compare_per_layer_report_0.html:以 HTML 页面形式展示逐层比较结果,包括每层 metric 值的趋势图和详细数据表格。 -
compare_per_layer_out_0.txt: 以表格的形式展示模型中每层 layer 的具体信息,包括各种指标、数据范围、量化 dtype 等。从左到右每一列分别表示:-
Index:op index。
-
mod_name:该 op 名字,若 op 为 module 类型,则显示该 module 在模型中的 prefix name,若为 function 类型,则不显示。
-
base_op_type:基准模型中该 op 的 type,可能是 module 类型或者 function 名称。
-
analy_op_type:待分析模型中该 op 的 type,可能是 module 类型或者 function 名称。
-
Shape:该 op 输出的 shape。
-
dtype:该 op 输出的数据类型。
-
qscale:该 op 输出的量化 scale。
-
L1:该 op 在两个模型中输出的 L1 距离。
-
COSINE:该 op 在两个模型中输出的余弦相似度。
-
ATOL:该 op 在两个模型中输出的绝对误差。
-
max_qscale_diff:该 op 在两个模型中输出最大相差了几个 scale。
-
base_model_min:基准模型中该 op 输出的最小值。
-
analy_model_min:待分析模型中该 op 输出的最小值。
-
base_model_max:基准模型中该 op 输出的最大值。
-
analy_model_max:待分析模型中该 op 输出的最大值。
-
base_model_mean:基准模型中该 op 输出的平均值。
-
analy_model_mean:待分析模型中该 op 输出的平均值。
-
same_in_qatbc_qdiff:该 op 在 qat bc 模型中相同位置的量化误差(以 scale 为单位)。仅在 export/convert 模式下有值。
-
same_in_intbc_qdiff:该 op 在定点 bc 模型中相同位置的量化误差(以 scale 为单位)。仅在 export/convert 模式下有值。
-
advice:对该 op 的诊断建议,包括数据范围过大、包含 inf 或 NaN、输出未设置高精度、clamp error 等。
-
-
compare_per_layer_out_0.csv: 以 csv 的格式展示每层的具体信息。内容和 txt 文件完全一致,csv 文件的存储格式方便您通过 excel 等软件打开分析。
sensitivity
模型中各个节点的敏感度排序。适用于 float 转 calibration 的精度掉点问题。
做精度调优时,推荐您始终开启 use_sensitivity_v2=True。相比默认输出,它会额外拆分出截断和舍入误差,并直接给出每个节点从 int8 换成 int16 的收益,同时提供 csv 和 HTML 报告,更便于分析。下文的输出说明也以 v2 为准。
参数
-
metric:相似度排序的 metric,默认
Metric.ATOL。可选值见 Metric 说明。 -
prefixes:指定前缀的 op 跑敏感度。默认 None,跑所有 op 的敏感度。
-
types:指定类型的 op 跑敏感度。默认 None,跑所有 op 的敏感度。同时指定
prefixes和types时,只有同时满足两个条件的 op 才会参与计算。 -
output_names:仅跑指定输出的敏感度。注意需使用
badcase_report.html中显示的输出名字。默认 None,跑所有输出的敏感度。 -
use_sensitivity_v2:是否使用 v2 版敏感度,推荐设置为 True。开启后,除了单节点量化敏感度,还会额外拆分出 round / clip 误差,并给出该节点分别在 qint8 和 qint16 下的敏感度以及两者的差值,便于直接判断把该节点提升到 int16 能带来多少收益。仅支持
analysis_model_type="fake_quant",因此一致性分析场景无法使用。 -
sensitivity_method:敏感度计算方法。仅在
use_sensitivity_v2=True且analysis_model_type="fake_quant"时可选。-
"ablation":默认方法,逐个改变 fake stub 状态并前向一次,观察输出误差。速度较慢,但一般不会爆显存。 -
"grad_x_error":使用梯度 × 误差估计敏感度,只需一次前向 + 反向,速度非常快,但对显存要求更高。该方法要求metric的scope为"all",且该 metric 必须返回可反向传播的标量 tensor。若自定义 metric 返回非 tensor、非标量 tensor 或不可导 tensor,会在运行时报错。
-
grad_x_error 的原理是把网络在某个 stub 处切开,量化在该处引入误差 ,将下游网络与 loss 的复合函数在当前工作点做一阶 Taylor 展开,用 近似该 stub 对最终 loss 的影响。
需要注意的是,使用 grad_x_error 时,结果表中的 metric 列名为 GRAD_X_ERROR(并附带 GRAD_MAGNITUDE、ERROR_MAGNITUDE),而不是您传入的 metric 名字。
旧版本中的 device 和 reserve 参数已废弃。传入这两个参数不会报错,但不再生效。device 请改为在 QuantAnalysis 初始化时通过 device_ids 指定;若需要查看不敏感的 op(可以尝试设置为 int8 以提升性能),请直接从结果表格的末尾往前看。
输出
结果文件按输出和 badcase 分别生成,命名为 output_{out_name}_case_{index}_sensitive_ops.txt / .csv / .pt,其中 out_name 为输出名字,index 为该 badcase 在 data_generator 中的 index。
out_name 由模型输出结构自动推导:模型只返回单个 tensor 时为空字符串(文件名形如 output__case_...);返回 list/tuple 时为 0、1;返回 dict 或 namedtuple 时为对应的 key,嵌套结构则以 - 连接,如 0-1。若使用 scope="all" 的 metric,输出名固定为 all。您可以通过 list(qa.badcase_report.output_to_badcase_info.keys()) 查看当前模型的实际输出名字,output_names 和 tune_bad_case 中需要使用这些名字。
除了每个 badcase 各自的结果,还会生成两份汇总表和一份 HTML 报告:
-
output_{out_name}_case_mean_sensitive_ops.*和output_{out_name}_case_worst_sensitive_ops.*:当topk > 1时,对该输出的多个 badcase 结果分别取平均值和最差值后的汇总表。相比单个 badcase 的结果,汇总表通常更稳定,更适合作为配置混合精度的依据。 -
sensitivity_v2_report.html:以 HTML 页面形式展示敏感度结果,包括各 metric 的排序柱状图和详细数据表格,页面中同样包含 mean 和 worst 敏感度表,列名可以交互排序。您可以通过排序后的变化趋势,决定从排序中的哪个算子开始把 qint8 设置为 qint16。
推荐优先查看 csv,可以综合不同 case 的敏感度、平均敏感度和最差敏感度一起分析精度问题。
文件中按照量化敏感度从高到低的顺序排列 op。主要列含义如下:
-
op_name:op 名字。
-
op_type:op 类型。
-
fake_stub_type:计算量化敏感的类型,包括:
-
output:仅量化该 op 输出的量化敏感度。
-
weight:仅量化该 op 权重的量化敏感度。
-
input-{n}:仅量化该 op 第 n 个输入的量化敏感度。
-
-
metric 列:按
{量化方式}_{metric}的形式展开成多列,metric即您传入的 metric 名字,如qint8_ATOL、qint16_ATOL、qint8-qint16_ATOL、round_ATOL、clip_ATOL、fp16_ATOL。各 metric 的取值范围和排序方向见 Metric 说明。其中:-
round / clip:分别表示只保留舍入误差、只保留截断误差时的敏感度,用于判断该节点的误差主要来自哪一种。
-
qint8 / qint16 / fp16:该节点在对应 dtype 下的敏感度。
-
qint8-qint16:两者的差值,数值越大说明把该节点从 int8 提升到 int16 的收益越大。结果默认按该列排序。
-
-
dtype:该 op 输出的量化 dtype。通常为 qint8/qint16/torch.float16。
-
flops:该 op 的计算量以及在整个模型计算量中的占比。
旧版本兼容说明
若未开启 use_sensitivity_v2,工具会输出旧版格式的敏感度结果:文件名为 output_{out_name}_case_{index}_{metric}_sensitive_ops.txt(带 metric,且不生成 csv),表格中只有一列 metric 值,fake_stub_type 列名为 sensitive_type,dtype 列名为 quant_dtype。旧版结果不包含 round / clip 拆分和 qint8-qint16 收益列,也无法用于 tune_bad_case。
一致性分析(analysis_model_type 为 pre_export / export / convert)目前只能使用旧版敏感度。
返回值
一个 dict,key 为输出名字,value 为 SensitivityTable 对象的列表,每个 badcase 对应一个表。SensitivityTable 可以通过 sort_by_column 重新排序。
结果表格示例如下(省略了部分 metric 列):
您可以将 qint8-qint16 列排名前 n 的 op 配置为 int16 来尝试提升量化模型精度。
若未开启 use_sensitivity_v2,返回值中每个 value 为敏感度 List,List 中每个元素是记录一个 op 敏感度信息的子 list,格式为 [op_name, sensitive_type, op_type, metric, dtype, flops]。
tune_bad_case
基于 sensitivity v2 的结果,在当前 badcase 上按敏感度顺序模拟把 qint8 提升为 qint16,观察累计误差的改善情况。它解决的是"拿到敏感度表之后,还要自己搭一版实验才能看到真实收益"的问题。
具体流程为:读取 output_{out_name}_case_{case}_sensitive_ops.pt 中保存的 SensitivityTable,按 qint8-qint16_{metric} 排序,随后逐个尝试将候选 qint8 临时改为 qint16:
-
若本次提升让最终输出的 metric 变好,则保留该 qint16 配置,并记录累计收益;
-
若没有收益,则恢复原本的 qint8 dtype 和原 scale;
-
达到
threshold或max_tuned_stubs后停止。
-
该接口仅支持
analysis_model_type="fake_quant"。 -
调用前必须先执行
sensitivity(use_sensitivity_v2=True),该接口依赖 v2 生成的output_{out_name}_case_{index}_sensitive_ops.pt。若使用旧版敏感度,会因找不到该文件而报FileNotFoundError。 -
多机多卡场景下仅 rank 0 执行实际搜索。
参数
-
outputs_config:按输出配置的搜索参数,key 为输出名字。单输出模型为空字符串
"",多输出模型通常为"0"、"1",使用scope="all"的 metric 时为"all"。每个输出的配置包含:-
metric:衡量 badcase 的 metric。
-
threshold:metric 达到该阈值后停止搜索。
-
max_tuned_stubs:最多调整多少个节点。
-
-
skip_prefix:跳过指定前缀的 op,key 为 op 名字前缀,value 为需要跳过的
fake_stub_type列表,如{"backbone": ["output", "weight"]}。
输出
output_{out_name}_tuned_case_{index}_sensitive_ops.txt/.csv/.pt:在敏感度表的基础上增加tuned_cumulative_{metric}列,记录每次调整后模型输出的 metric 变化。有值的行即为被提升到 int16 后确实带来改善的节点。
clean
清除中间结果。仅保留比较结果等文件。
ModelProfiler 类
统计模型 forward 过程中,每一层算子的输入输出等信息。
参数
-
model: 需要统计的模型。
-
out_dir: 相关文件保存的路径。
该类仅支持通过 with 语句的方式使用。
该类中其中各个 method 如下:
get_info_manager
获得管理每个 op 信息的结构体。
返回值
管理存储的每个 op 信息的结构体 OpRunningInfoManager。其中两个重要的接口如下:
table
在一个表格中展示单个模型统计量。存储到 statistic.txt 文件中。
参数
-
out_dir:statistic.txt 文件的存储路径,默认 None,存储到 self.out_dir。
-
prefixes:需要统计的模型中 op 的 prefixes。默认统计所有 op。
-
types:需要统计的模型中 op 的 type。默认统计所有 op。
-
with_stack: 是否显示每个 op 在代码中对应的位置。
输出
statistic.txt 文件,从左到右每一列分别为:
-
Index:op index。
-
Op Name:op type,module 类名或者 function 名。
-
Mod Name:若是 module 类,则显示该 module 在模型中的 prefix name;若是 function 类型,则显示该 function 所在的 module prefix name。
-
Attr:input/output/weight/bias。
-
Dtype:tensor 的数据类型。
-
Scale:tensor 的 scale。
-
Min:当前 tensor 的最小值。
-
Max:当前 tensor 的最大值。
-
Mean:当前 tensor 的平均值。
-
Var:当前 tensor 中数值的方差。
-
Shape:tensor shape。
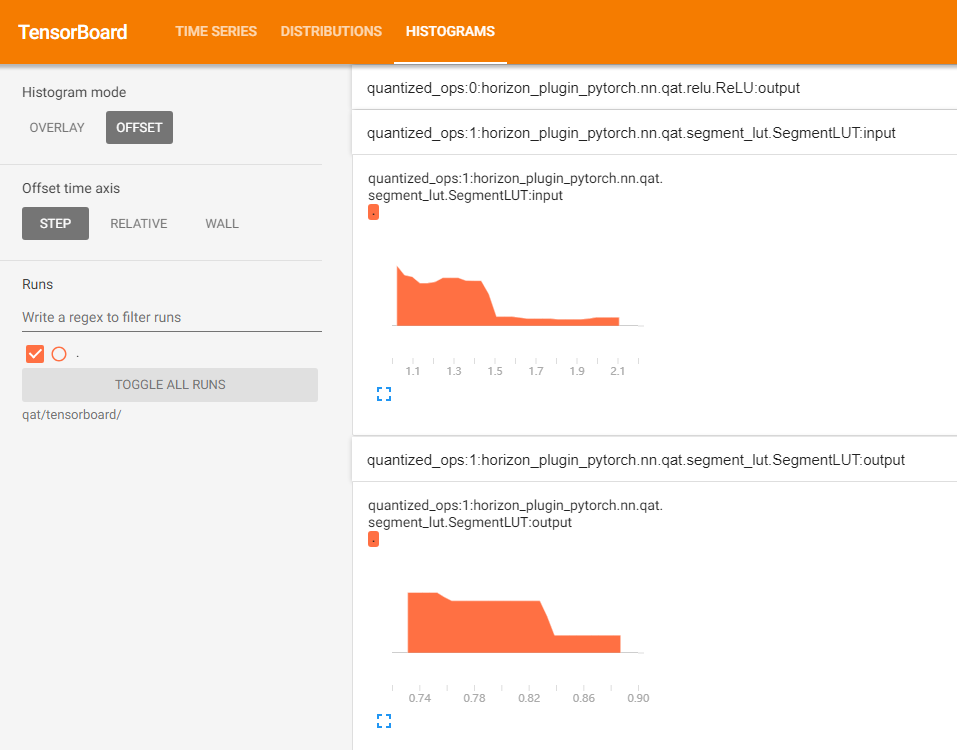
tensorboard
在 tensorboard 中显示每一层输入输出直方图。
参数
-
out_dir:tensorboard 相关文件保目录。默认保存到 self.out_dir/tensorboard 目录下。
-
prefixes:需要统计的模型中 op 的 prefixes。默认统计所有。
-
types:需要统计的模型中 op 的 type。默认统计所有。
-
force_per_channel:是否以 per_channel 量化的方式展示直方图。
输出
tensorboard 文件,打开后截图如下:
HbirModelProfiler 类
该类的功能和使用方式与 ModelProfiler 类完全一致。请参考 ModelProfiler 类 进行使用。
由于 hbir 模型的特殊格式,qat hbir 模型在 forward 时需添加索引 0。